Pourquoi je construis une usine logicielle sur mesure en 2026
Introduction
Je suis ingénieure logiciel et produit. Je suis aussi mère de 4 humains (et de 5 chats), ce qui me rend obsédée par l’organisation, les workflows, les automatisations et l’optimisation du temps. Cette histoire raconte comment ces deux faits m’ont menée d’un assistant IA dans mon IDE à la construction d’une usine logicielle à laquelle je peux confier une fonctionnalité (ou un lot de correctifs et d’améliorations), et la laisser tourner.
Comme je l’écris sur ma page d’accueil : Avant, j’écrivais du code. Maintenant, je construis les systèmes qui l’écrivent. Cet article explique pourquoi et comment c’est arrivé, et où j’en suis en septembre 2026. Le fonctionnement de l’usine fera l’objet d’un prochain article.
La version courte, avant la longue :
timeline
    title De ChatGPT à une usine logicielle
    2022 : ChatGPT dans un onglet de navigateur
    2023 : Copilot Pro dans l'IDE
    2024 : Copilot Pro+, pour livrer plus
    2025 : Spec Kit, les specs avant le code
         : Tests unitaires comme barrière de qualité
         : Formation 1, TDD, BDD et clean architecture, React
    2026 : Formation 2, avec Claude Code, Python
         : BDD, TDD, clean architecture sur chaque projet
         : Expérimentation d'agents autonomes avec Claude, Ollama et OpenClaw, Langfuse pour les traces
         : Orchestrateur sur mesure comme usine logicielle, développement complet d'epics et de stories
2023 à 2025 : Copilot, puis Spec Kit
Avant Copilot, il y avait ChatGPT dans un onglet de navigateur. J’ai commencé mon parcours avec Copilot Pro en 2023, parce que c’était simple à démarrer dans mon IDE. Comme je livrais de plus en plus, je suis passée à Pro+ fin 2024.
En 2025, j’ai commencé à structurer mon processus de développement avec l’IA :
- Spec Kit, pour définir les spécifications avant le développement.
- Des tests unitaires dans mes produits, comme barrière de qualité pour le développement piloté par l’IA.
J’ai construit plusieurs fonctionnalités sur différents projets de cette façon, en m’appuyant sur les fonctionnalités cloud de Copilot pour passer à l’échelle mes processus et mes développements. Les résultats n’étaient pas toujours ceux attendus, mais ils se sont améliorés avec les techniques de prompting et les progrès des modèles. Ce que j’ai compris durant cette période, c’est l’importance de la création d’artefacts pour un développement en plusieurs étapes, à contexte fermé.
Cette méthode a cessé de suffire pour les grosses fonctionnalités, qui demandent du développement back-end et front-end avec de la planification. Il me manquait un processus de spécification plus complet, pour définir les fonctionnalités avec les bonnes pratiques de conception logicielle. Ce manque m’a poussée à explorer d’autres techniques, et m’a menée à une formation.
Formation au clean code et au TDD
J’ai suivi deux formations aux pratiques TDD/BDD/clean architecture avec Michaël Azerhad chez Wealcome, la première en 2025 pour des projets front-end en React, puis une seconde en 2026 pour du back-end en Python. La dernière s’est faite entièrement avec l’IA (le harness Claude Code) et m’a ouvert l’esprit à un autre niveau de codage avec l’IA, avec des standards de qualité élevés.
Trois choses que je mets maintenant en place sur chaque projet que je construis :
- Le Behaviour-Driven Development, pour des spécifications claires de user stories et de scénarios.
- Le Test-Driven Development, pour tester le code à partir de ces scénarios.
- Les règles de clean architecture, pour un dépôt structuré.
Juin 2026 : Copilot a changé ses prix, alors j’ai changé d’outils
En juin 2026, Copilot a changé ses prix et ajouté des limites sur les quotas d’utilisation des modèles. Les tokens sont devenus (hélas) trop chers pour mes projets personnels. Alors j’ai arrêté, et je suis passée à Claude et à d’autres modèles open source, avec Ollama et OpenClaw.
En expérimentant avec OpenClaw, j’ai vite (et douloureusement) compris le besoin d’outils de contrôle du budget, de monitoring et d’observabilité, pour comprendre ce qui se passe derrière les harnesses.
L’agent qui a brûlé des tokens en silence
La partie douloureuse, c’était une configuration d’agents que je testais : un architecte, un planificateur, un développeur et un testeur, qui tournaient dans OpenClaw avec des bots de chat Mattermost. Je lançais une issue GitHub pour de la planification ou du développement, et l’agent se bloquait. Aucun retour dans le chat, aucune réponse, et des tokens consommés sans savoir ce qui se passait derrière.
J’avais besoin d’un outil de monitoring, alors j’ai pris Langfuse. Les traces ont montré l’agent en boucle sur un accès à un outil qu’il ne savait pas exécuter. J’ai aussi eu beaucoup de mal à obtenir une orchestration fluide des agents, et sans le vouloir je me suis retrouvée à faire beaucoup de babysitting, à les relancer et à leur demander « où en es-tu ? » en permanence. Même si les résultats étaient bons (les fonctionnalités développées marchaient, les couches de la clean architecture étaient respectées), cette configuration n’était pas tenable pour passer à un processus de développement entièrement autonome.
Quelques problèmes que Langfuse m’a aidée à détecter :
- Des processus bloqués ou en boucle sur des erreurs d’outils.
- Des instructions mal suivies.
- Des agents en boucle sur des problèmes d’environnement, sans réussir à les corriger.
Ce que j’en ai compris : le prompt doit être adapté avec le bon jeu de skills, pour que l’agent sache exécuter ses outils. Le réglage fin du harness et de son outillage, du modèle et de ses paramètres, est la clé de bons résultats, surtout avec les modèles open source.
Alors j’ai commencé à construire la mienne
Après de nombreuses expérimentations et plusieurs projets personnels avec ces workflows, j’ai commencé à construire mon propre système d’orchestration, en m’appuyant sur la méthodologie BMAD pour des processus pilotés par les spécifications. Voici le système général tel qu’il tourne aujourd’hui :
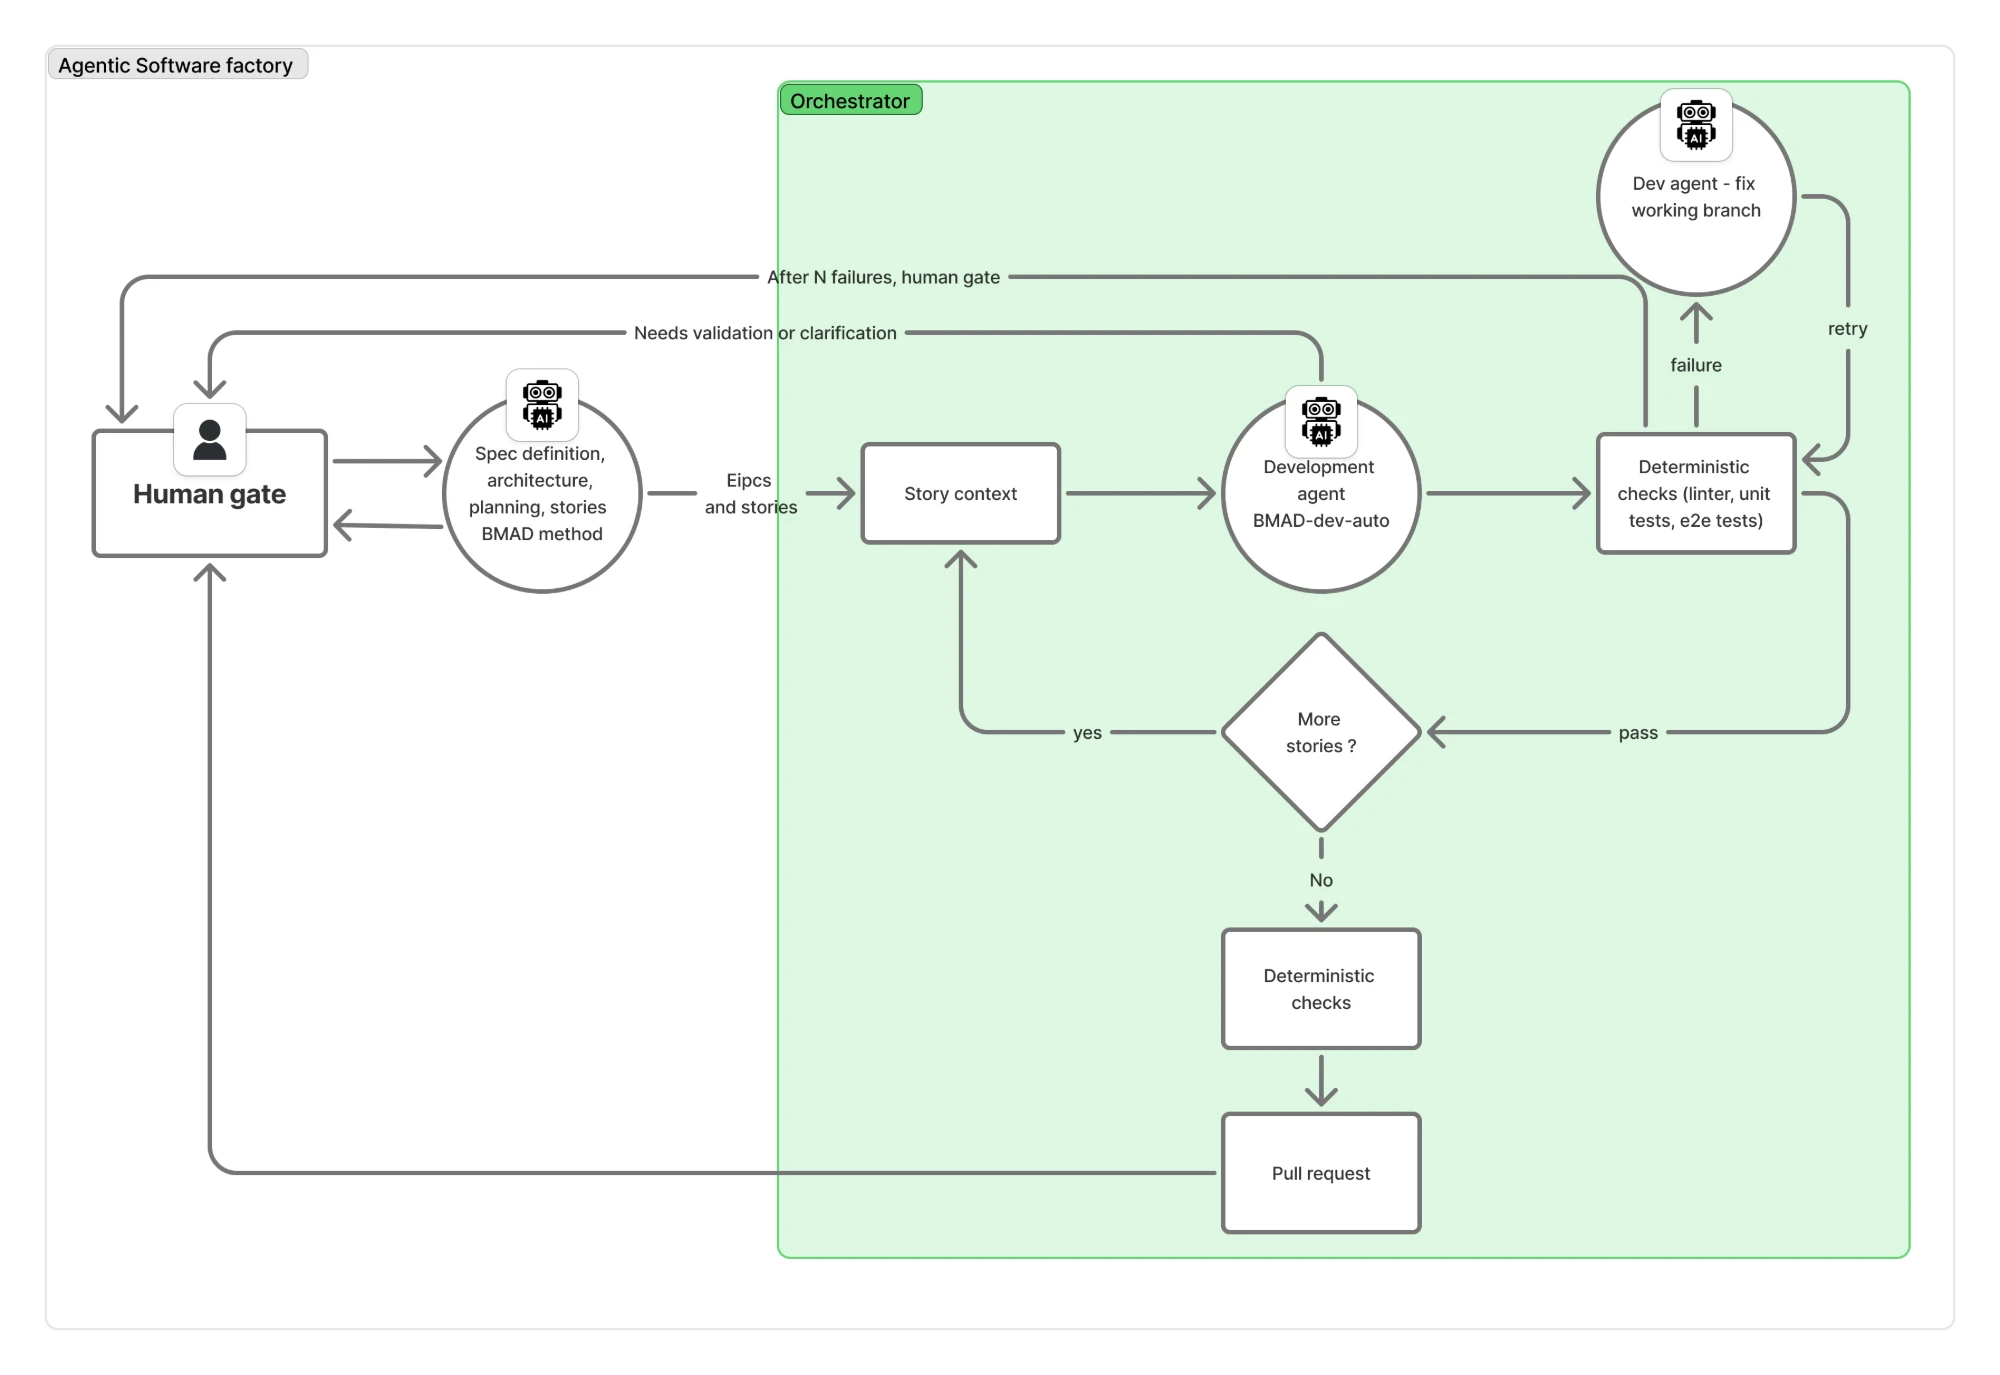
La définition des spécifications se fait avant l’orchestrateur, avec la méthode BMAD : spécifications, architecture, planification et stories sont écrites avec l’IA, et validées par un humain. Ce qui en sort, ce sont des epics avec leurs stories, suivant le processus agile bien connu. Elles entrent dans l’orchestrateur.
L’orchestrateur est une simple API Python. Pour chaque story, il exécute la même boucle :
- Le contexte de la story.
- L’agent de développement : un agent dev BMAD en mode auto, dans un harness lancé en mode non interactif via son SDK, dans sa propre session pour la story. Les harnesses tournent dans une configuration agnostique du modèle via LiteLLM. Quand l’agent a besoin d’une validation ou d’une clarification, la story passe à la validation humaine (le « human gate » du schéma).
- Les vérifications déterministes : linter, tests unitaires, tests e2e.
- Si ça passe, la story suivante. En cas d’échec, un agent dev corrige la branche de travail et les vérifications sont relancées. Après N échecs, la story s’arrête à la validation humaine.
Quand il n’y a plus de stories, les vérifications déterministes tournent une dernière fois sur toute la branche, et l’orchestrateur ouvre une pull request. La pull request passe par le workflow CI/CD, puis par la validation humaine.
Cette configuration me permet de garder le contrôle à tout moment, et surtout de remonter aux sessions des agents pour chaque story, si nécessaire.
Comme je l’ai mentionné dans l’article sur le développeur polyglotte, après quelques expérimentations j’ai observé que pour l’open source, l’orchestration du pipeline est la clé de bons résultats. Les vérifications déterministes et la configuration donnent aux agents un environnement propre pour commencer à travailler.
Où j’en suis en septembre 2026
Les outils de codage avec l’IA deviennent assez bons pour que le goulot d’étranglement ne soit plus la génération de code. Le goulot d’étranglement, c’est maintenant l’orchestration, le contrôle qualité, le coût, l’observabilité, et savoir quand un humain doit intervenir.
Les modèles frontière, avec un raisonnement poussé et un grand contexte, sont capables d’orchestrer des agents efficacement dans leurs harnesses, par des boucles par exemple. Mais cela peut consommer beaucoup de tokens et devenir coûteux, puisque le contexte peut grandir de façon exponentielle.
Je trouve l’orchestration sur mesure utile pour quatre choses principales :
- L’optimisation du coût en tokens.
- La flexibilité de modèle (ne pas dépendre d’un fournisseur).
- Un environnement de développement fermé pour les agents, pour la sécurité (les agents n’accèdent pas à ce qu’ils ne devraient pas).
- Une validation humaine à chaque étape du processus de développement (seulement quand c’est nécessaire).
Je garde le contrôle sur l’écriture des spécifications, les décisions d’architecture, et les tests et la validation finale. Entre les deux, l’orchestrateur et son processus se chargent de l’écriture du code, de sorte que je ne suis appelée que lorsqu’une décision humaine est nécessaire.
Avant, j’écrivais du code… Maintenant, je construis les systèmes qui l’écrivent.