Por qué estoy construyendo una fábrica de software a medida en 2026
Introducción
Soy ingeniera de software y de producto. También soy madre de 4 humanos (y 5 gatos), lo que me vuelve obsesiva con la organización, los workflows, las automatizaciones y la optimización del tiempo. Esta historia cuenta cómo esos dos hechos me llevaron de un asistente de IA en mi IDE a construir una fábrica de software a la que puedo entregar una funcionalidad (o un lote de correcciones y mejoras), y dejarlo corriendo.
Como digo en mi página de inicio: Antes escribía código. Ahora construyo los sistemas que lo escriben. Este artículo cuenta por qué y cómo pasó, y dónde estoy en septiembre de 2026. Cómo funciona la fábrica será el tema de un próximo artículo.
La versión corta, antes de la larga:
timeline
    title De ChatGPT a una fábrica de software
    2022 : ChatGPT en una pestaña del navegador
    2023 : Copilot Pro en el IDE
    2024 : Copilot Pro+, para entregar más
    2025 : Spec Kit, specs antes del código
         : Tests unitarios como barrera de calidad
         : Formación 1, TDD, BDD y clean architecture, React
    2026 : Formación 2, con Claude Code, Python
         : BDD, TDD, clean architecture en cada proyecto
         : Experimentos con agentes autónomos con Claude, Ollama y OpenClaw, Langfuse para las trazas
         : Orquestador a medida como fábrica de software, desarrollo completo de epics y stories
De 2023 a 2025: Copilot, luego Spec Kit
Antes de Copilot estaba ChatGPT en una pestaña del navegador. Empecé mi camino con Copilot Pro en 2023, porque era fácil arrancar con él en mi IDE. A medida que entregaba más, pasé a Pro+ a finales de 2024.
En 2025 empecé a dar estructura a mi proceso de desarrollo con IA:
- Spec Kit, para definir las especificaciones antes del desarrollo.
- Tests unitarios en mis productos, como barrera de calidad para el desarrollo guiado por IA.
Construí varias funcionalidades en distintos proyectos de esta forma, apoyándome en las funciones cloud de Copilot para escalar mis procesos y desarrollos. Los resultados no siempre eran los esperados, pero mejoraron con las técnicas de prompting y con el progreso de los modelos. Lo que entendí en este periodo fue la importancia de crear artefactos para un desarrollo en varias etapas, con contexto cerrado.
Esta metodología dejó de ser suficiente para funcionalidades grandes, que requieren desarrollo back-end y front-end con planificación. Me faltaba un proceso de especificación más completo, para definir las funcionalidades con buenas prácticas de diseño de software. Esa carencia me empujó a investigar otras técnicas, y me llevó a una formación.
Formación en clean code y TDD
Seguí dos formaciones en prácticas de TDD/BDD/clean architecture con Michaël Azerhad en Wealcome, la primera en 2025 para proyectos front-end con React, y una segunda en 2026 para back-end con Python. La última fue completamente con IA (el harness Claude Code) y me abrió la mente a otro nivel de programación con IA, con estándares de calidad altos.
Tres cosas que ahora aplico en cada proyecto que construyo:
- Behaviour-Driven Development, para especificaciones claras de user stories y escenarios.
- Test-Driven Development, para probar el código a partir de esos escenarios.
- Las guías de clean architecture, para un repositorio estructurado.
Junio de 2026: Copilot cambió sus precios, así que cambié de herramientas
En junio de 2026 Copilot cambió sus precios y añadió limitaciones en las cuotas de uso de modelos. Los tokens se volvieron (tristemente) demasiado caros para mis proyectos personales. Así que paré, y cambié a Claude y a otros modelos open source, con Ollama y OpenClaw.
Experimentando con OpenClaw, entendí rápido (y con dolor) la necesidad de herramientas de control de presupuesto, monitoreo y observabilidad, para entender qué pasa detrás de los harnesses.
El agente que quemó tokens en silencio
La parte dolorosa fue una configuración de agentes que estaba probando: un arquitecto, un planificador, un desarrollador y un tester, corriendo en OpenClaw con bots de chat en Mattermost. Yo lanzaba un GitHub issue para planificación o desarrollo, y el agente se quedaba atascado. Sin feedback en el chat, sin respuesta, y tokens consumiéndose sin saber qué pasaba detrás.
Necesitaba una herramienta de monitoreo, así que elegí Langfuse. Las trazas mostraron al agente en bucle sobre un acceso a una herramienta que no sabía ejecutar. También me costó mucho hacer una orquestación fluida de los agentes, sin querer acabé haciendo mucho babysitting de los agentes, relanzándolos y preguntando “¿Cómo vas con el proceso?” constantemente. Aunque los resultados eran buenos (las funcionalidades desarrolladas funcionaban y se respetaban las capas de la arquitectura), esta configuración no era sostenible para escalar hacia un proceso de desarrollo totalmente autónomo.
Algunos de los problemas que Langfuse me ayudó a detectar:
- Procesos bloqueados o en bucle por errores de herramientas.
- Instrucciones no seguidas correctamente.
- Agentes en bucle por problemas de entorno, sin lograr corregirlos.
Lo que entendí de esto: el prompt tiene que adaptarse con el conjunto correcto de skills, para que el agente sepa ejecutar sus herramientas. Afinar el harness y sus herramientas, el modelo y sus parámetros, es clave para obtener buenos resultados, sobre todo con modelos open source.
Así que empecé a construir la mía
Tras muchos experimentos y varios proyectos personales con estos workflows, empecé a construir mi propio sistema de orquestación, apoyándome en la metodología BMAD para procesos guiados por especificaciones. Este es el sistema general tal como funciona hoy:
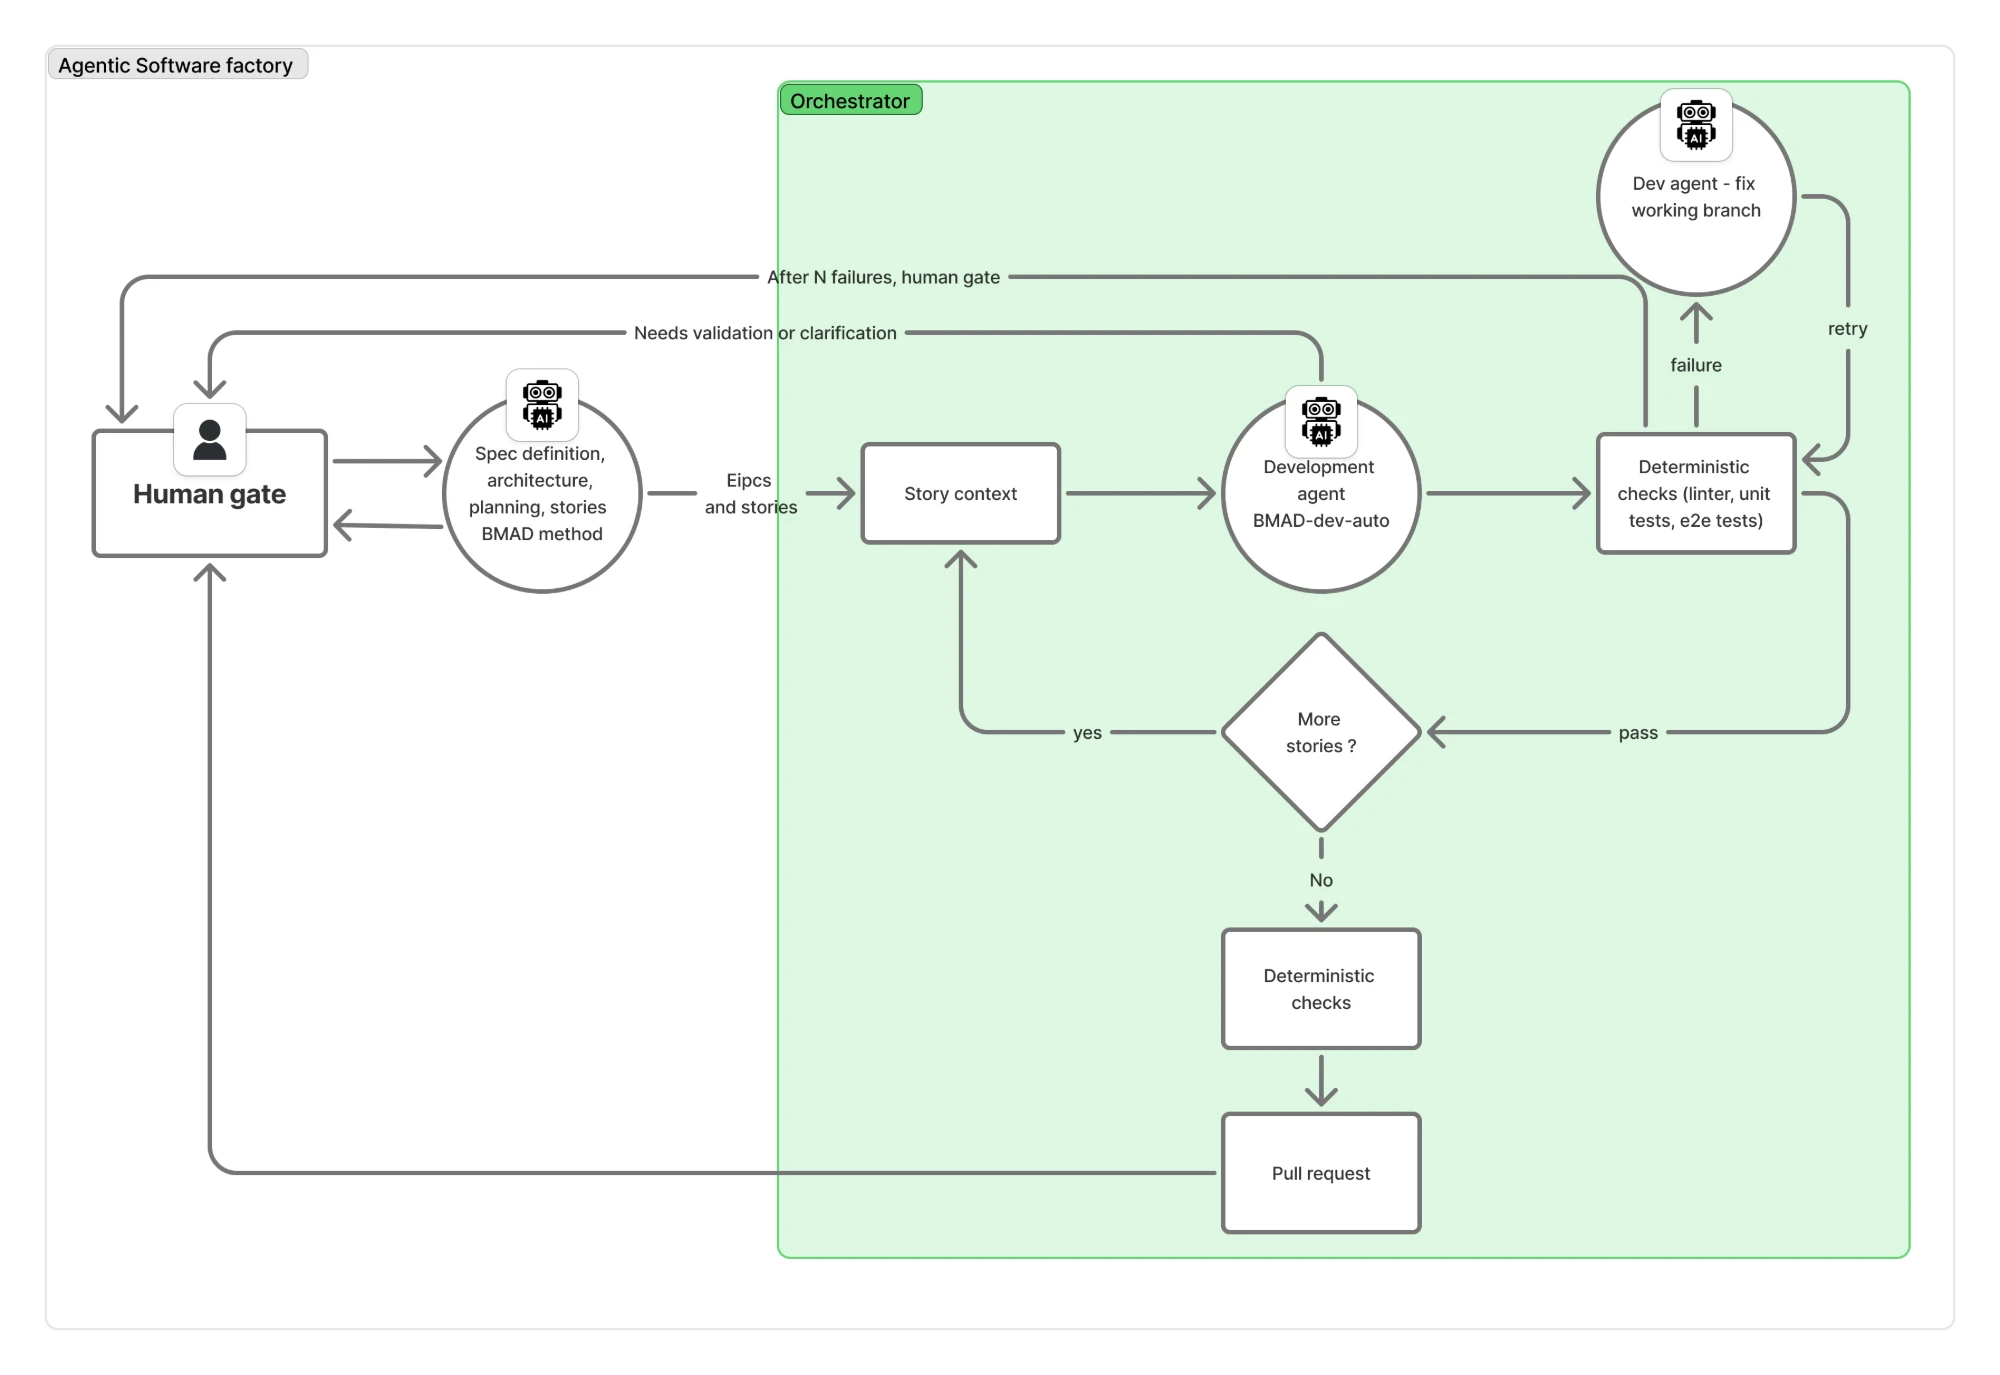
La definición de especificaciones ocurre antes del orquestador, con el método BMAD: especificaciones, arquitectura, planificación y stories se escriben con IA, y las valida un humano. Lo que sale son epics con stories, siguiendo el conocido método ágil. Esas entran al orquestador.
El orquestador es una simple API en Python. Para cada story, ejecuta el mismo bucle:
- Contexto de la story.
- Agente de desarrollo: un agente dev de BMAD en modo auto, en un harness corriendo en modo no interactivo a través de su SDK, en su propia sesión para la story. Los harnesses corren en una configuración agnóstica del modelo a través de LiteLLM. Cuando el agente necesita una validación o una aclaración, la story pasa a la validación humana (el “human gate” del esquema).
- Verificaciones determinísticas: linter, tests unitarios, tests e2e.
- Si pasa, la siguiente story. Si falla, un agente dev corrige la rama de trabajo y las verificaciones corren de nuevo. Tras N fallos, la story se detiene en la validación humana.
Cuando no quedan stories, las verificaciones determinísticas corren una vez más sobre toda la rama, y el orquestador abre una pull request. La pull request pasa por el workflow de CI/CD y luego a la validación humana.
Esta configuración me permite tener el control en todo momento, y sobre todo volver a las sesiones de los agentes para cada story si es necesario.
Como mencioné en el artículo sobre el programador políglota, tras algunos experimentos observé que para el open source, la orquestación del pipeline es la clave para buenos resultados. Las verificaciones determinísticas y la configuración dan a los agentes un entorno limpio para empezar a trabajar.
Dónde estoy en septiembre de 2026
Las herramientas de programación con IA se están volviendo bastante buenas para que el atasco ya no sea la generación de código. El atasco ahora es la orquestación, el control de calidad, el costo, la observabilidad, y saber cuándo tiene que intervenir un humano.
Los modelos de frontera, con razonamiento alto y contexto grande, son capaces de orquestar agentes de forma eficiente dentro de sus harnesses, con bucles por ejemplo. Sin embargo, esto puede consumir muchos tokens y volverse costoso, ya que el contexto puede crecer de forma exponencial.
La orquestación a medida me resulta útil para cuatro cosas principales:
- Optimización del costo en tokens.
- Flexibilidad de modelo (no depender de un proveedor).
- Un entorno de desarrollo cerrado para los agentes, por seguridad (los agentes no acceden a lo que no deben).
- Una validación humana en cada paso del proceso de desarrollo (solo cuando es necesario).
Tengo el control sobre la elaboración de especificaciones, las decisiones de arquitectura y las pruebas y validación finales; entretanto, el orquestador y su proceso se encargan de la escritura del código, de modo que solo se requiere mi intervención cuando es necesaria una decisión humana.
Antes escribía código… Ahora construyo los sistemas que lo escriben.