Comparer l'orchestration agentique avec le harness Claude Code : performance et consommation de tokens
Lecture rapide
Le test
La même fonctionnalité, construite huit fois à partir de la même spec. Six builds sont passés par mon orchestrateur : trois workflows, chacun avec Opus et Sonnet, puis avec Sonnet et Haiku. Deux builds étaient chacun une seule session Claude Code, sans orchestration autour.
Le résultat
Les huit builds ont livré le même jeu. Un script a joué les mêmes 6 000 parties sur chaque build, et les huit ont donné exactement le même résultat. J'ai aussi joué à chaque version sur la tablette, sans voir de différence.
Le coût
De 15,68 $ à 16,56 $ sur Opus et Sonnet, de 2,67 $ à 4,84 $ sur Sonnet et Haiku, aux prix de l'API. Les sessions simples sont estimées de 0,25 $ à 2,33 $. Les modèles ont multiplié le coût par trois à six ; la méthode l'a beaucoup moins fait bouger.
Mon avis
La configuration dont j'avais besoin il y a six mois est déjà couverte par les harnesses. La suite : une fonctionnalité plus complexe, avec le modèle ajusté à chaque story.
Introduction
Quand j’ai commencé à explorer et tester des modèles open source en mai 2026, je me suis retrouvée à faire beaucoup de babysitting avec mes agents. J’avais une configuration OpenClaw avec plusieurs personas d’agents, chacun avec son rôle, et aller d’une issue à une PR n’avait rien d’évident. J’avais un processus de développement clair, mais les agents avaient besoin d’être guidés, et d’une orchestration plus claire. Alors j’ai commencé à en construire une.
En octobre 2026, des harnesses comme Claude Code ont intégré ces fonctionnalités dans leurs systèmes, et ils orchestrent plutôt bien. Mais je voulais savoir ce que cela donnait en consommation de tokens. Quand le harness orchestre, un seul agent connaît le processus et le parcourt en boucle, pour chaque fonctionnalité et chaque story, dans une seule session. Mon hypothèse était donc que la consommation de tokens augmente quand le harness orchestre dans une seule session, ce qui revient plus cher au total. Et si on découpait en une session par story ? Et enfin, que donne la comparaison avec mon orchestration sur mesure, qui découpe le processus d’implémentation en trois étapes : planification, implémentation et review ?
C’est la première évaluation annoncée dans l’article précédent, Pourquoi il faut faire des évaluations d’IA sur vos projets et vos dépôts en 2026 : une tâche, huit configurations sur des modèles Claude avec Claude Code comme harness, un run chacune, évaluées par les tests de mon propre dépôt. La même fonctionnalité construite sur des modèles à poids ouverts fera l’objet d’un article à venir.
1. La configuration et les workflows
Les specs détaillées, l’intention et l’architecture sont produites par une étape précédente, faite avec un humain dans la boucle et validée par un humain avant que l’implémentation ne commence. Les résultats ci-dessous viennent de ce scénario. Les specs ont été produites avec la méthode BMAD pour les spécifications produit, et chaque run d’évaluation est parti de la même base de code et des mêmes specs.
La fonctionnalité
La fonctionnalité est un jeu Snake pour Familio, une application personnelle que je construis avec mes enfants pour suivre les tâches ménagères avec des récompenses, et qui a un espace de jeux. La stack est une application Node.js full-stack en TypeScript, avec Astro, React, Vitest et Playwright. Dans le jeu, le serpent du joueur chasse des méchants serpents pilotés par l’ordinateur, grandit en les mangeant et accélère au fur et à mesure. La spécification a donné un epic avec trois stories :
- le moteur de la chasse ;
- la chasse dans le record et sur la carte du parent ;
- la tuile, la grille et les écrans de la chasse.
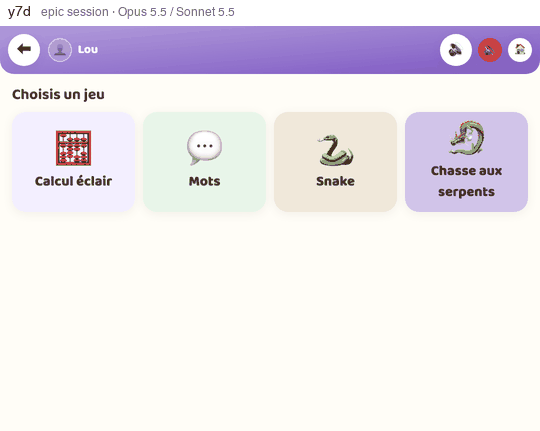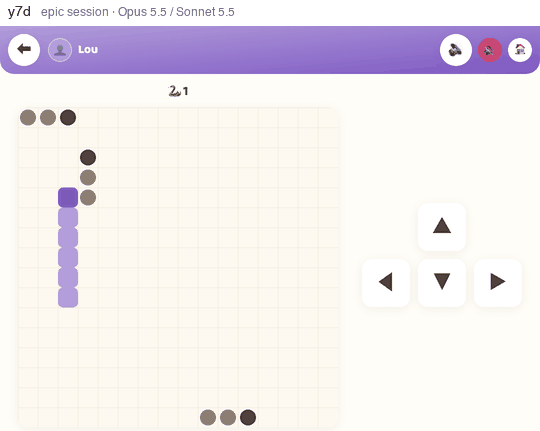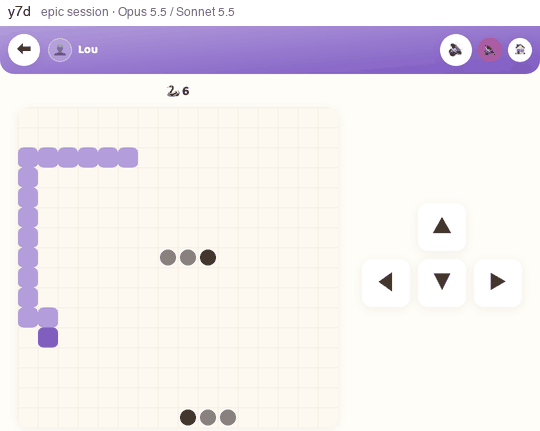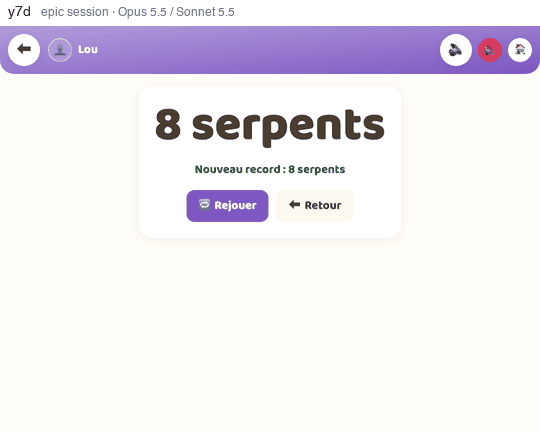
La même partie scriptée a été enregistrée sur chaque build. Celle-ci vient de l’un des huit builds (y7d dans les tableaux ci-dessous).
La spec est passée par toute la chaîne BMAD : exigences, design UX, architecture, découpage en stories, puis la spec et ses stories. Chaque build est parti du même commit. Chacun des huit builds a ajouté entre 726 et 787 lignes de code de production et entre 1 450 et 2 142 lignes de tests unitaires. La rédaction de la spec et ses reviews ne sont comptées dans aucun des chiffres de tokens ci-dessous.
Les configurations
Chaque configuration a tourné via mon orchestrateur, avec Claude Code comme harness.
| Build | Workflow | Session qui orchestre | Planification et review | Implémentation |
|---|---|---|---|---|
y3f | staged | aucune, l’orchestrateur lance chaque étape | Opus 5.5 | Sonnet 5.5 |
t4e | story session | Sonnet 5.5 | Opus 5.5 | Sonnet 5.5 |
y7d | epic session | Sonnet 5.5 | Opus 5.5 | Sonnet 5.5 |
h5k | staged | aucune | Sonnet 5.5 | Haiku 5.5 |
j5c | story session | Sonnet 5.5 | Sonnet 5.5 | Haiku 5.5 |
v2m | epic session | Sonnet 5.5 | Sonnet 5.5 | Haiku 5.5 |
k3x | Claude Code simple | une session Sonnet 5.5 | — | — |
r8n | Claude Code simple | une session Haiku 5.5 | — | — |
Deux limites de cette grille : aucun build n’avait Opus pour orchestrer, et le template simple ne prend qu’un seul modèle, donc k3x et r8n ne correspondent pas à la paire où Sonnet planifie et Haiku implémente. j5c et v2m ont tourné sur une version plus récente de l’orchestrateur et du template, avec les mêmes prompts.
Les quatre workflows
Chaque étape d’agent écrit un fichier marqueur avec son statut. Une étape qui ne laisse aucun marqueur lisible est configurée pour être relancée une fois. Un agent bloqué consulte un modèle senior quand le run en désigne un, et, sinon, se met en attente d’une intervention humaine. Les trois premiers workflows partagent tout ce qui entoure le build : la gate de spec avant, puis la vérification par les tests unitaires, la génération des tests end-to-end (e2e), la quality gate e2e et la rétrospective.
Staged. Mon orchestrateur lance chaque étape comme une session d’agent à part : trois sessions par story, chacune sur son propre modèle. Le diagramme montre où le travail repart en cas d’échec.
flowchart TB
  gate[Gate de spec, modèle plan]:::agent
  subgraph story [Chaque story, agents relancés une fois]
    plan[Planification, modèle plan]:::agent --> impl[Implémentation, modèle implémentation]:::agent
    impl --> verify(Vérification : tests unitaires):::check
    verify --> review[Review, modèle review]:::agent
  end
  gate --> plan
  verify -. échec : refaire, max 2 .-> impl
  review --> more{Autres stories ?}:::check
  more -->|oui| plan
  more -->|non| gen[Génération E2E, modèle plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. échec : refaire, max 2 .-> gen
  e2e --> retro[Rétrospective, modèle plan]:::agent
  retro --> pr([Poussé, lien pour la PR]):::check
  story -. bloqué .-> senior[Consultation senior, si défini]:::agent
  verify -. échoue encore .-> senior
  senior -->|décision| story
  senior -. non défini .-> park([Mise en attente pour une personne]):::gate
  gate -. bloqué .-> park
  e2e -. échoue encore .-> park
  retro -. rejeté .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Story session. Une session Claude Code par story lance les trois mêmes étapes comme sous-agents, sur les mêmes modèles : c’est le harness qui lance les étapes, au lieu de mon orchestrateur. La vérification tourne après la session, et, en cas d’échec, la configuration prévoit de renvoyer toute la session. La story suivante démarre une nouvelle session.
flowchart TB
  gate[Gate de spec, modèle plan]:::agent
  subgraph session [Une session par story, Sonnet, relancée une fois]
    plan[Sous-agent Planification]:::agent --> impl[Sous-agent Implémentation]:::agent --> review[Sous-agent Review]:::agent
  end
  gate --> session
  review --> verify(Vérification : tests unitaires):::check
  verify -. échec : refaire, max 2 .-> session
  verify --> more{Autres stories ?}:::check
  more -->|oui, nouvelle session| session
  more -->|non| gen[Génération E2E, modèle plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. échec : refaire, max 2 .-> gen
  e2e --> retro[Rétrospective, modèle plan]:::agent
  retro --> pr([Poussé, lien pour la PR]):::check
  session -. bloqué .-> senior[Consultation senior, si défini]:::agent
  verify -. échoue encore .-> senior
  senior -->|décision| session
  senior -. non défini .-> park([Mise en attente pour une personne]):::gate
  gate -. bloqué .-> park
  e2e -. échoue encore .-> park
  retro -. rejeté .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Epic session. Une seule session pour tout l’epic exécute les trois étapes pour chaque story, dans l’ordre, puis la vérification tourne une fois pour l’epic.
flowchart TB
  gate[Gate de spec, modèle plan]:::agent
  subgraph session [Une seule session pour cet epic, Sonnet, relancée une fois]
    plan[Sous-agent Planification]:::agent --> impl[Sous-agent Implémentation]:::agent --> review[Sous-agent Review]:::agent
    review --> more{Story suivante ?}:::check
    more -->|oui| plan
  end
  gate --> session
  more -->|non| verify(Vérification : tests unitaires):::check
  verify -. échec : refaire, max 2 .-> session
  verify --> gen[Génération E2E, modèle plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. échec : refaire, max 2 .-> gen
  e2e --> retro[Rétrospective, modèle plan]:::agent
  retro --> pr([Poussé, lien pour la PR]):::check
  session -. bloqué .-> senior[Consultation senior, si défini]:::agent
  verify -. échoue encore .-> senior
  senior -->|décision| session
  senior -. non défini .-> park([Mise en attente pour une personne]):::gate
  gate -. bloqué .-> park
  e2e -. échoue encore .-> park
  retro -. rejeté .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Claude Code simple. Une session reçoit le dossier de spec et un prompt, qui lui demande de faire passer les tests et la quality gate complète. Pas de gate de spec, pas d’étapes, pas de vérification, pas d’étapes e2e, pas de rétrospective et pas de consultation senior. L’orchestrateur ne fait que le checkout, le commit et le push ; il ne lance jamais les tests, donc c’est l’évaluation après le run qui tranche.
flowchart TB
  pin(Commit fixé, installation):::check --> build[Une session construit cet epic]:::agent
  build -. pas de marqueur : relance une fois .-> build
  build -->|fini| push(Commit et push):::check
  push --> pr([Lien pour la PR]):::check
  build -. bloqué .-> park([Mise en attente pour une personne]):::gate
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Sources.
- Les specs suivent la BMAD Method, qui se décrit comme “Agile AI-Driven Development” (documentation de la BMAD Method).
- Dans la story session et l’epic session, Claude Code délègue à ses propres sous-agents, chacun sur son propre modèle : “Control costs by routing tasks to faster, lower-cost models like Haiku” (Create custom subagents, documentation de Claude Code).
2. Les constats
Avant les runs, je m’attendais à ce que la paire Sonnet et Haiku soit la moins chère, mais aussi celle qui échouerait, ou au moins qui échouerait plusieurs fois.
J’ai été surprise que chaque version du workflow donne le même résultat du point de vue de l’expérience utilisateur : le jeu fonctionnait correctement, les écrans étaient bien développés, les interactions marchaient, tout était équivalent d’une version à l’autre. J’ai testé toutes les versions sur la tablette : j’ai joué à chacune plusieurs fois, j’ai perdu et gagné quelques fois sur chacune, et je n’ai observé aucune différence. Honnêtement, je ne m’attendais pas au même résultat sur toutes les versions.
L’équivalence est mesurée sur les huit builds :
- Un script a joué les mêmes 6 000 parties sur les huit moteurs de jeu, avec les mêmes tirages aléatoires et les mêmes touches : les huit ont renvoyé le même état à chaque étape. Une partie scriptée de 124 ticks montre aussi le même plateau à chaque tick sur le vrai écran de chaque build.
- Les tests unitaires de chaque build, lancés sur le code des sept autres, passent dans 8 377 exécutions de cas sur 8 470 ; ses specs e2e, sur les applications des sept autres, dans 3 231 sur 3 234. Chaque échec est un test lié à un choix que la spec laissait ouvert.
- Les huit sont au vert sur la quality gate complète du dépôt (toute la suite de l’application, pas seulement les tests de la fonctionnalité), avec 93,3 à 93,6 % de couverture de lignes.
- Ma note sur la tablette, attribuée pour sept des huit sans savoir à quel build je jouais, a donné le même résultat à chaque fois.
Une précaution avant les chiffres : chaque configuration a tourné une fois. Une étude de 2026 sur des agents de code dans un seul dépôt a trouvé qu’un gain mesuré du taux de réussite, sur le nombre de tâches qu’un seul dépôt peut fournir, “cannot be separated from the agent’s run-to-run variance”. Toute différence ci-dessous est une différence entre deux runs.
| Build | Workflow | Modèles | Coût | Tokens de prompt | Tokens de sortie | Minutes d’exécution |
|---|---|---|---|---|---|---|
y3f | staged | Opus / Sonnet | 16,50 $ | 22,3 M | 219 k | 122 |
t4e | story session | Opus / Sonnet | 15,68 $ | 20,2 M | 234 k | 85 |
y7d | epic session | Opus / Sonnet | 16,56 $ | 21,9 M | 230 k | 103 |
h5k | staged | Sonnet / Haiku | 2,77 $ à 3,50 $ | 17,8 M | 209 k | 90 |
j5c | story session | Sonnet / Haiku | 3,33 $ à 4,84 $ | 27,2 M | 277 k | 61 |
v2m | epic session | Sonnet / Haiku | 2,67 $ à 4,01 $ | 19,8 M | 255 k | 54 |
k3x | simple | Sonnet | 2,33 $ (estimation) | 6,57 M | 70 k | 19 |
r8n | simple | Haiku | 0,25 $ à 1,11 $ (estimation) | 12,25 M | 132 k | 40 |
Le coût est un prix, pas une facture : ma passerelle LiteLLM a chiffré chaque requête aux tarifs de l’API (novembre 2026), alors que les builds ont tourné sur mon abonnement. La passerelle n’avait pas de prix pour Haiku au-delà de 100 k tokens de contexte, donc son chiffre est une borne basse ; le chiffre haut est l’estimation de Claude Code lui-même. Les deux builds simples ne sont jamais passés par la passerelle : leurs dollars sont des estimations et leurs tokens sont le décompte de l’orchestrateur, donc je les compare sur les tokens, et de façon approximative. Les tokens de prompt comprennent les lectures du cache.
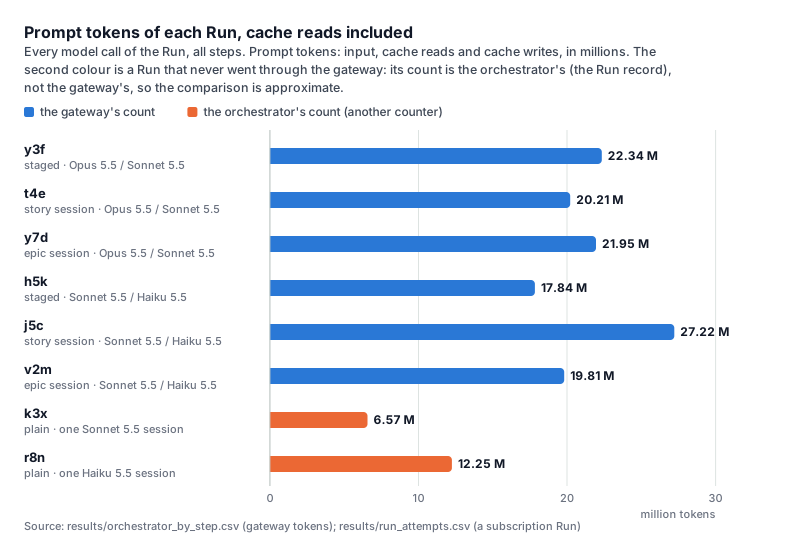
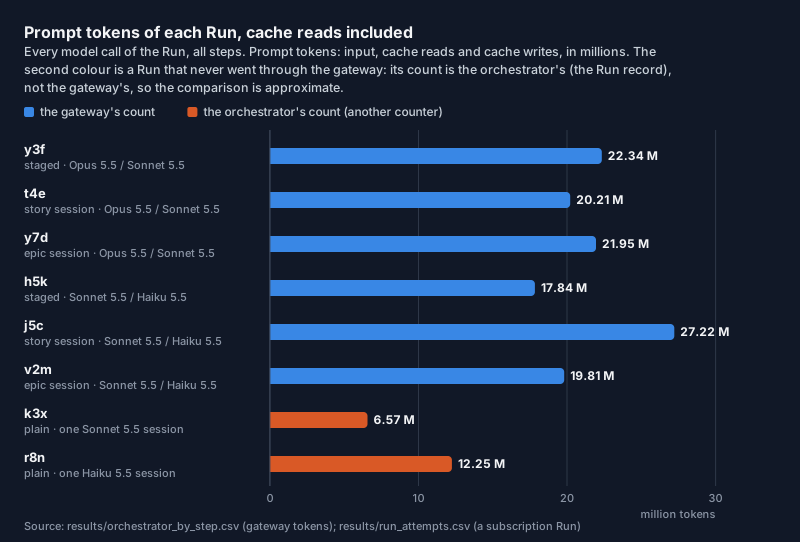
Trois choses ressortent :
- La paire de modèles a multiplié le coût par trois à six. Les nombres de tokens des deux paires sont proches ; c’est le prix par token qui diffère.
- La méthode l’a peu fait bouger sur Opus et Sonnet (20,2 M à 22,3 M tokens de prompt), et davantage sur Sonnet et Haiku (17,8 M à 27,2 M).
- Les sessions Claude Code simples ont utilisé le moins de tokens et le moins de temps, sans aucune des étapes autour du build.
Le troisième point est celui que je retiens : la configuration dont j’avais besoin il y a six mois est déjà couverte par les harnesses.
Sources.
- Un run par configuration : l’étude de la variance d’un run à l’autre sur un seul dépôt (Skill Issue: Lessons from Optimizing Repository SKILLs for Coding Agents, prépublication 2026).
- Les prix de l’API derrière la colonne du coût, en novembre 2026. Haiku 5.5 a un second prix, plus élevé, pour les prompts de plus de 100 000 tokens (Pricing, documentation de l’API Claude).
- Claude Code calcule son propre montant en dollars “locally from token counts at list price”, comme une estimation (Manage costs effectively, documentation de Claude Code).
3. Quelques enseignements intéressants
| # | Question | Réponse courte |
|---|---|---|
| 1 | Mon orchestration avant ou après le développement est-elle un garde-fou qui aide les agents de faible capacité à atteindre l’objectif ? | Pas sur cette fonctionnalité. La vérification et la gate e2e n’ont arrêté aucun défaut dans les six runs orchestrés, et la session Haiku simple a abouti au même jeu sans aucune gate. |
| 2 | Ces étapes sont-elles inutiles avec des modèles de forte capacité ? | Elles ont trouvé peu de choses à réparer : 7 patchs de review sur les trois builds Opus et Sonnet, aucun pour un problème qu’un utilisateur aurait rencontré. Un run par configuration ne permet pas d’aller jusqu’à “inutiles”. |
| 3 | La consommation de tokens est-elle équivalente pour les mêmes modèles avec des méthodes différentes ? | Sur Opus et Sonnet, oui (20,2 M à 22,3 M tokens de prompt). Sur Sonnet et Haiku, non (17,8 M à 27,2 M), même si le run le plus gourmand a répété une étape deux fois. |
| 4 | Quel mélange de méthode et de modèles est le moins efficace, ou le plus coûteux sans que ça en vaille la peine ? | La paire Opus et Sonnet, quelle que soit la méthode : trois à six fois le coût pour le même jeu et des tests e2e légèrement plus solides. |
| 5 | Quelle étape de mon orchestrateur est inutile ou redondante ? | Sur cette spec, l’étape de génération e2e : 0 à 5 tests ajoutés alors que les stories avaient déjà écrit les leurs. Je la garde pour l’instant comme filet de sécurité, et la rétrospective pour l’auto-apprentissage. |
| 6 | Les tests sont-ils équivalents : e2e générés, tests unitaires, couverture ? | La couverture, oui : 93,3 à 93,6 % des lignes. Ce que les tests détectent, non : 8 à 13 des 13 défauts injectés dans l’écran de jeu. |
| 7 | Combien de relances, d’échecs et de déblocages par le senior ? | Neuf tentatives échouées sur trois runs, aucune causée par le code, et aucune consultation senior dans aucun run. Les runs m’ont attendue environ 133 minutes, dont 131 pour l’infrastructure. |
Plus de détails sur chacune de ces questions ci-dessous.
1. Mon orchestration est-elle un garde-fou qui aide les agents de faible capacité à atteindre l’objectif ?
| Build | Vérification unitaire en échec sur le code | Gate e2e en échec sur un test | Runs de tests lancés par les agents eux-mêmes (unitaires / e2e) | Quality gate complète après le run |
|---|---|---|---|---|
y3f | 0 sur 3 | 0 sur 4 | 30 / 20 | vert |
t4e | 0 sur 3 | 0 sur 1 | 22 / 8 | vert |
y7d | 0 sur 1 | 0 sur 1 | 29 / 14 | vert |
h5k | 0 sur 3 | 0 sur 1 | 42 / 17 | vert |
j5c | 0 sur 3 | 0 sur 4 | 32 / 14 | vert |
v2m | 0 sur 1 | 0 sur 1 | 30 / 11 | vert |
k3x | pas de gate | pas de gate | 8 / 5 | vert |
r8n | pas de gate | pas de gate | 13 / 5 | vert |
Les gates n’avaient rien à attraper : les agents avaient lancé les mêmes suites eux-mêmes avant de passer la main (30 runs unitaires et 20 runs e2e pour le seul y3f), et corrigé ce qui échouait à l’intérieur de l’étape. Les gates ont donc confirmé que le build était au vert. La session Haiku simple, sans aucune gate, est évaluée au vert elle aussi ; ses tests sont une autre histoire (question 6).
J’ai injecté 16 défauts dans le moteur de chaque build pour voir ce que ses tests détectent (question 6) : les huit ratent les trois mêmes, ceux que les critères d’acceptation ne décrivent pas. Les huit builds ont aussi écrit les mêmes 18 fichiers de production. Ils suivent la spec de près ; aucun run n’a fait varier la spec, donc la part du résultat qu’elle explique n’est pas mesurée.
2. Ces étapes sont-elles inutiles avec des modèles de forte capacité ?
| Build | Reviewer | Durée d’une review | Patchs de review | Défauts de code ou manques de tests relevés par la rétrospective |
|---|---|---|---|---|
y3f | Opus | 69 à 739 s | 3 | 9 |
t4e | Opus | 104 à 804 s | 2 | 11 |
y7d | Opus | 78 à 774 s | 2 | 6 |
h5k | Sonnet | 28 à 39 s | 0 | 1 |
j5c | Sonnet | 21 à 40 s | 0 | 0 |
v2m | Sonnet | 19 à 29 s | 0 | 1 |
k3x | pas de review | — | — | pas de rétrospective |
r8n | pas de review | — | — | pas de rétrospective |
Avec Opus, les étapes ont lu le code, relancé les suites, et ajouté des tests et des constats ; aucun des 7 patchs n’a corrigé un problème qu’un utilisateur aurait rencontré. Avec Sonnet, elles ont surtout confirmé ce que l’agent d’implémentation avait déjà lancé : cinq des neuf reviews n’ont lancé aucune commande. Les rétrospectives ont relevé 26 défauts de code ou manques de tests sur les trois builds Opus et Sonnet, et 2 sur les trois autres ; une rétrospective les signale et ne répare rien.
Les données ne permettent pas d’aller jusqu’à “inutiles”, cela dit : le reviewer et l’agent d’implémentation ont changé ensemble (Opus a relu le code de Sonnet, Sonnet celui de Haiku), et aucune session Claude Code simple n’a tourné sur Opus.
3. La consommation de tokens est-elle équivalente pour les mêmes modèles avec des méthodes différentes ?
| Build | Workflow | Tokens de prompt | Par rapport au build staged des mêmes modèles | Tokens de sortie | Appels d’outils |
|---|---|---|---|---|---|
y3f | staged, Opus / Sonnet | 22,3 M | — | 219 k | 323 |
t4e | story session, Opus / Sonnet | 20,2 M | −10 % | 234 k | 284 |
y7d | epic session, Opus / Sonnet | 21,9 M | −2 % | 230 k | 291 |
h5k | staged, Sonnet / Haiku | 17,8 M | — | 209 k | 214 |
j5c | story session, Sonnet / Haiku | 27,2 M | +53 % | 277 k | 325 |
v2m | epic session, Sonnet / Haiku | 19,8 M | +11 % | 255 k | 245 |
k3x | simple, Sonnet | 6,57 M | autre compteur, non comparable | 70 k | 47 |
r8n | simple, Haiku | 12,25 M | autre compteur, non comparable | 132 k | 75 |
Sur Opus et Sonnet, les trois méthodes ont coûté de 15,68 $ à 16,56 $, avec 6 % d’écart. C’est proche des quelque 3 à 4 % d’écart entre la passerelle et l’estimation de Claude Code lui-même sur les mêmes runs. Sur Sonnet et Haiku, la story session a utilisé 53 % de tokens de plus que le run staged, mais j5c a refait deux fois sa génération e2e (question 7) et a tourné sur une version plus récente de l’orchestrateur, donc un seul run ne permet pas de dire que la méthode en est la cause.
Les chiffres ne permettent pas de trancher sur mon hypothèse. Sur Opus et Sonnet, l’epic session, où un seul agent parcourt en boucle tout le processus, a utilisé un peu moins de tokens que le run staged ; sur Sonnet et Haiku, 11 % de plus. La session Sonnet simple a utilisé environ un tiers des tokens des builds Opus et Sonnet, et la session Haiku simple de la moitié aux deux tiers de ceux des builds Sonnet et Haiku, mais elles ont sauté la gate de spec, la génération e2e et la rétrospective, donc la comparaison n’est pas à périmètre égal. Haiku seul a pris environ deux fois plus de tokens et deux fois plus de temps que Sonnet seul, pour le même résultat au vert, et environ la moitié de ce temps a été perdue sur une commande tuée (question 7).
4. Quel mélange de méthode et de modèles est le moins efficace ?
| Build | Modèles | Coût | Défauts d’écran détectés par ses specs e2e (sur 13) | Par ses tests de composants | Par l’un ou l’autre |
|---|---|---|---|---|---|
y3f | Opus / Sonnet | 16,50 $ | 11 | 10 | 12 |
t4e | Opus / Sonnet | 15,68 $ | 10 | 10 | 11 |
y7d | Opus / Sonnet | 16,56 $ | 11 | 12 | 13 |
h5k | Sonnet / Haiku | 2,77 $ à 3,50 $ | 8 | 9 | 10 |
j5c | Sonnet / Haiku | 3,33 $ à 4,84 $ | 9 | 10 | 12 |
v2m | Sonnet / Haiku | 2,67 $ à 4,01 $ | 7 | 11 | 12 |
k3x | Sonnet, simple | 2,33 $ (estimation) | 10 | 10 | 11 |
r8n | Haiku, simple | 0,25 $ à 1,11 $ (estimation) | 8 | 6 | 8 |
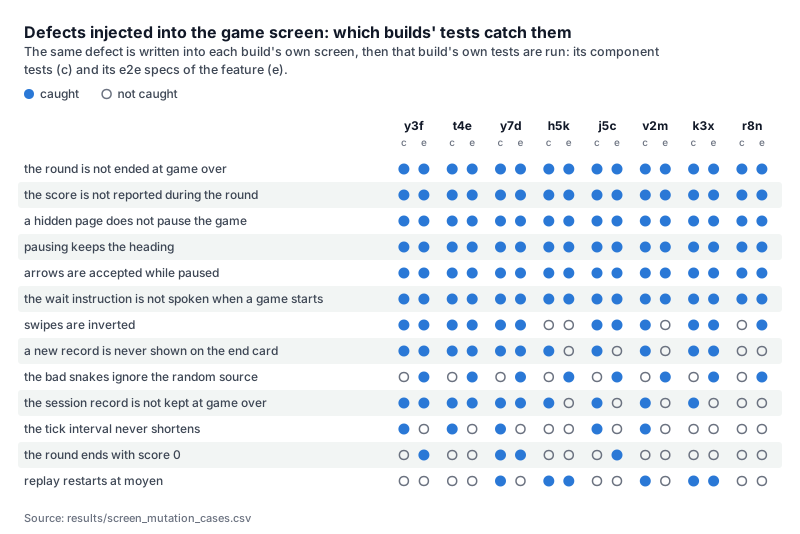
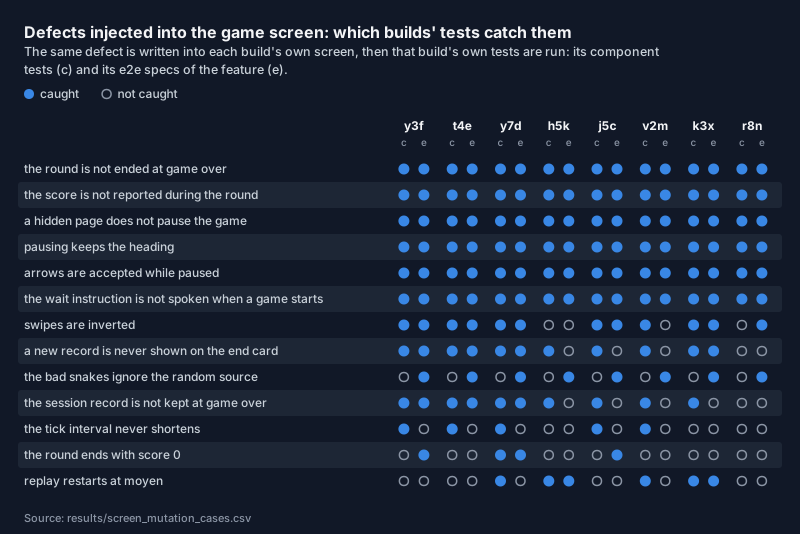
La paire Opus et Sonnet est celle qui coûte cher sans gagner grand-chose. Ce que le surcoût a acheté se trouve dans les tests : j’ai injecté les mêmes 13 défauts dans l’écran de jeu de chaque build, et lancé sur chacun ses propres tests. Les specs e2e des builds Opus et Sonnet en détectent 10 à 11, contre 7 à 9 pour les builds Sonnet et Haiku ; avec les tests de composants, l’écart se referme presque. La session Sonnet simple est dans la même fourchette, et la session Haiku simple arrive dernière.
5. Quelle étape de mon orchestrateur est inutile ou redondante ?
| Build | Gate de spec | Build | Génération E2E | Rétrospective | Tests ajoutés par la génération e2e |
|---|---|---|---|---|---|
y3f staged, Opus / Sonnet | 0,60 $ | 8,74 $ | 2,43 $ | 4,73 $ | 3 |
t4e story session, Opus / Sonnet | 0,49 $ | 10,75 $ | 1,08 $ | 3,37 $ | 5 |
y7d epic session, Opus / Sonnet | 0,55 $ | 11,81 $ | 1,01 $ | 3,18 $ | 1 |
h5k staged, Sonnet / Haiku (borne basse) | 0,18 $ | 2,12 $ | 0,15 $ | 0,32 $ | 0 |
j5c story session, Sonnet / Haiku (borne basse) | 0,17 $ | 2,39 $ | 0,46 $ | 0,30 $ | 0 |
v2m epic session, Sonnet / Haiku (borne basse) | 0,18 $ | 2,02 $ | 0,19 $ | 0,28 $ | 0 |
k3x simple, Sonnet (estimation) | pas d’étape | 2,33 $ | pas d’étape | pas d’étape | — |
r8n simple, Haiku (estimation) | pas d’étape | 0,25 $ à 1,11 $ | pas d’étape | pas d’étape | — |
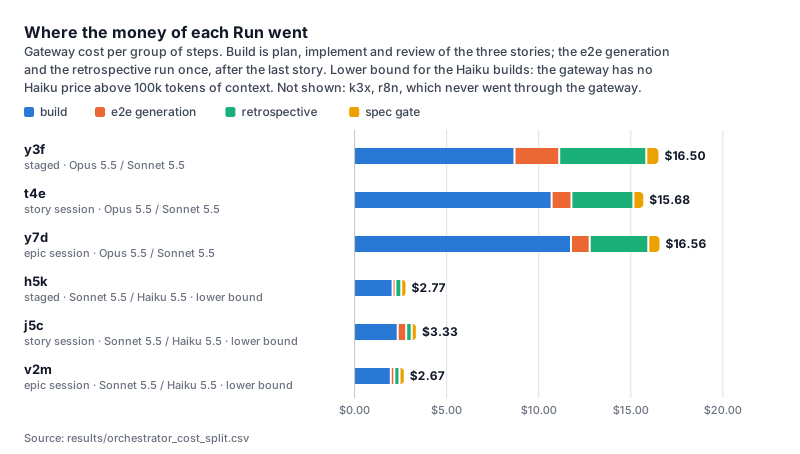
Sur cette spec, l’étape de génération e2e est redondante. La spec demande aux stories 2 et 3 d’écrire leur propre spec e2e, donc l’étape arrivait alors que la couverture était déjà en place. Chaque modèle a écrit que les stories avaient couvert la fonctionnalité, puis a ajouté 0 à 5 tests, qui sont tous passés sur un code que personne n’avait modifié.
Après le build, la rétrospective est l’étape la plus chère dans cinq des six runs : 9 à 29 % du coût de chaque run. Les six se sont terminées sur le même verdict, accepté avec des points en suspens. La vérification et la gate e2e n’ont jamais arrêté de défaut, mais elles sont déterministes et durent environ 10 et 630 secondes, et elles sont la preuve que le build est au vert. Les étapes de planification et la gate de spec n’ont pas été analysées.
Je pense que la génération e2e est un filet de sécurité contre d’éventuels bugs, et la rétrospective sert à l’auto-apprentissage. Je garde donc les deux pour l’instant. Je les garderais pendant l’onboarding d’un projet ; une fois que chaque run est stable (pas de bugs, pas de régressions), on pourrait les retirer pour économiser des tokens.
6. Les tests sont-ils équivalents : e2e générés, tests unitaires, couverture ?
| Build | Cas de tests unitaires écrits | Cas e2e écrits | Couverture de lignes du dépôt | Couverture de lignes des écrans de jeu qu’il a écrits | Défauts du moteur détectés (sur 16) |
|---|---|---|---|---|---|
y3f | 100 | 24 | 93,62 % | 100 % | 13 |
t4e | 95 | 27 | 93,63 % | 100 % | 13 |
y7d | 102 | 24 | 93,64 % | 100 % | 13 |
h5k | 93 | 17 | 93,38 % | 95,28 % | 13 |
j5c | 111 | 22 | 93,61 % | 99,56 % | 13 |
v2m | 117 | 18 | 93,64 % | 100 % | 12 |
k3x | 79 | 19 | 93,63 % | 100 % | 13 |
r8n | 74 | 18 | 93,32 % | 94,78 % | 13 |
La couverture du dépôt ne distingue pas les builds. Celle des écrans de jeu, un peu : h5k et r8n, à 95 %, sont aussi les deux builds dont les tests détectent le moins de défauts d’écran (question 4). Les builds Sonnet et Haiku ont écrit des suites e2e plus courtes (17 à 22 cas, contre 24 à 27), et les sessions simples ont écrit le moins de tests unitaires, l’essentiel de l’écart portant sur les écrans de l’enfant. v2m a écrit le plus de tests unitaires des huit, et c’est le seul build dont les tests du moteur ratent un défaut que les autres détectent. Aucune suite e2e des huit ne remarque que le jeu cesse d’accélérer.
7. Combien de relances, d’échecs et de déblocages par le senior ?
| Build | Tentatives échouées | Étapes renvoyées | Relances automatiques | Mises en attente | Consultations senior | Minutes à m’attendre |
|---|---|---|---|---|---|---|
y3f | 3 | 2 | 0 | 1 | 0 | 100 |
t4e | 0 | 0 | 0 | 0 | 0 | 0 |
y7d | 0 | 0 | 0 | 0 | 0 | 0 |
h5k | 3 | 0 | 0 | 3 | 0 | 32 |
j5c | 3 | 2 | 0 | 1 | 0 | 1 |
v2m | 0 | 0 | 0 | 0 | 0 | 0 |
k3x | 0 | 0 | 0 | 0 | pas de senior | 0 |
r8n | 0 | 0 | 0 | 0 | pas de senior | 0 |
Aucune des neuf tentatives échouées n’était un agent bloqué sur le code. Dans y3f et j5c, trois fois, la gate e2e n’a pas pu démarrer, parce que le serveur de test d’un agent précédent occupait encore son port, et ces échecs ont renvoyé l’étape de génération e2e deux fois dans chaque run (1,48 $ et 0,31 $ de travail refait). Dans h5k, une mise à jour de sous-module a dépassé son délai deux fois, et une étape d’implémentation s’est bloquée sur une phrase de la spec, à laquelle j’ai répondu en moins de deux minutes. Aucun run n’a consulté de modèle senior : les trois builds Opus et Sonnet ont tourné sans, et j5c et v2m avaient Opus 5.5 comme senior et ne l’ont jamais appelé.
La plus grosse perte de temps n’était pas une étape : la suite e2e complète prend environ dix minutes, la durée de la fenêtre de commande du harness, donc quand un agent la lance au premier plan, elle est tuée, et l’agent laisse son serveur de test sur le port. C’est ce qui a coûté à y3f ses 100 minutes de mise en attente, et à la session Haiku simple environ 20 de ses 40 minutes.
J’ai une session Claude sur l’hôte qui surveille les runs : quand un run est mis en attente, je reçois un message de Claude. Le temps en attente, c’est donc le temps où j’étais loin de mon téléphone ou de mon ordinateur (wow, pas mal de temps, visiblement).
Conclusion
Après avoir vu que les résultats étaient les mêmes sur les différentes configurations de modèles, je pense que la fonctionnalité était trop simple et facile : elle n’était pas assez difficile, même pour des modèles de très faible capacité (l’application avait déjà un premier jeu Snake, et 69 à 87 % de chaque nouveau composant d’écran de jeu est l’écran de ce jeu, adapté). Les métriques des builds diffèrent les unes des autres, mais le résultat était quand même le même, ce qui m’a fait réfléchir à la complexité réelle de la tâche.
La configuration dont j’avais besoin il y a six mois est déjà obsolète, avec Claude Code en tout cas. La tech va vite, et il faut suivre ! Cela laisse de la place pour d’autres explorations, sur d’autres configurations et d’autres méthodes.
Après ces observations, j’ai une question de plus : y a-t-il, dans ces résultats, la preuve que c’est la définition de la spec qui garantit le résultat final, quels que soient le modèle et la méthode ? Une grande partie de la planification était déjà faite en amont, donc il restait très peu de décisions à l’agent. Les huit builds ont écrit les mêmes 18 fichiers de production, mais aucun run n’a fait varier la spec, donc cette évaluation ne peut pas y répondre.
Pour mes prochaines fonctionnalités, je lancerais soit le workflow staged avec un mélange de modèles, pour plus de contrôle, soit une session par story. Dans les deux cas, le modèle devrait être ajusté à la complexité de chaque story, puisque la complexité de la story pourrait changer les résultats. Je vais donc intégrer dans mon orchestrateur la possibilité de changer de modèle par story.
Prochaine étape : j’évaluerai une fonctionnalité plus complexe avec différentes configurations, pour observer les différences.