Comparar la orquestación agéntica con el harness de Claude Code: rendimiento y consumo de tokens
Lectura rápida
La prueba
La misma funcionalidad, construida ocho veces desde la misma spec. Seis builds pasaron por mi orquestador: tres workflows, cada uno con Opus y Sonnet, y luego con Sonnet y Haiku. Dos builds fueron cada uno una sola sesión de Claude Code, sin orquestación alrededor.
El resultado
Los ocho builds entregaron el mismo juego. Un script jugó las mismas 6,000 partidas en cada build, y los ocho dieron exactamente el mismo resultado. También jugué cada versión en la tablet y no vi ninguna diferencia.
El costo
De $15.68 a $16.56 con Opus y Sonnet, de $2.67 a $4.84 con Sonnet y Haiku, a precios de API. Las sesiones simples se estiman entre $0.25 y $2.33. Los modelos movieron el costo de tres a seis veces; el método lo movió mucho menos.
Mi opinión
La configuración que necesitaba hace seis meses ya la cubren los harnesses. Lo siguiente: una funcionalidad más compleja, con el modelo ajustado a cada story.
Introducción
Cuando empecé a explorar y probar modelos open source en mayo de 2026, me encontré haciendo mucho babysitting a mis agentes. Tenía una configuración de OpenClaw con varios perfiles de agente, cada uno con su propio rol, y llegar de un issue a una PR no era sencillo. Tenía un proceso de desarrollo claro, pero los agentes necesitaban guía y una orquestación más clara. Así que empecé a construir una.
Saltemos a octubre de 2026: harnesses como Claude Code ya integraron estas funciones en sus sistemas, y orquestan bastante bien. Pero tenía curiosidad por el consumo de tokens en este caso. Cuando el harness orquesta, un agente conoce el proceso y lo recorre en bucles, para cada funcionalidad y cada story, en una sola sesión. Así que mi hipótesis era que el consumo de tokens aumenta cuando el harness orquesta en una sola sesión, y que eso sale más caro en total. ¿Y si se divide en una sesión por story? Y por último, ¿cómo se compara con mi orquestación a medida, que divide el proceso de implementación en tres pasos: planificación, implementación y review?
Esta es la primera evaluación anunciada en el artículo anterior, Por qué necesitas hacer evaluaciones de IA en tus proyectos y repositorios en 2026: una tarea, ocho configuraciones con modelos de Claude y Claude Code como harness, un run cada una, calificadas por los propios tests de mi repositorio. La misma funcionalidad construida con modelos open-weight es el tema de un artículo posterior.
1. La configuración y los workflows
Las specs detalladas, la intención y la arquitectura salen de un paso previo, hecho con un humano en el bucle y validado por un humano antes de que empiece la implementación propiamente dicha. Los resultados de abajo vienen de ese escenario. Las specs se produjeron con el método BMAD para especificaciones de producto, y cada run de evaluación partió de la misma base de código y de las mismas specs.
La funcionalidad
La funcionalidad es un juego Snake para Familio, una aplicación personal que estoy construyendo con mis hijos para dar seguimiento a las tareas del hogar con recompensas, y un espacio de juegos. El stack es una aplicación full-stack en Node.js con TypeScript, con Astro, React, Vitest y Playwright. En el juego, la serpiente del jugador caza serpientes malas controladas por la computadora, crece a medida que se las come y acelera conforme avanza. La especificación dio como resultado un epic con tres stories:
- el motor de la caza;
- la caza en el récord y en la tarjeta de los padres;
- el recuadro del juego, la cuadrícula y las pantallas de la caza.
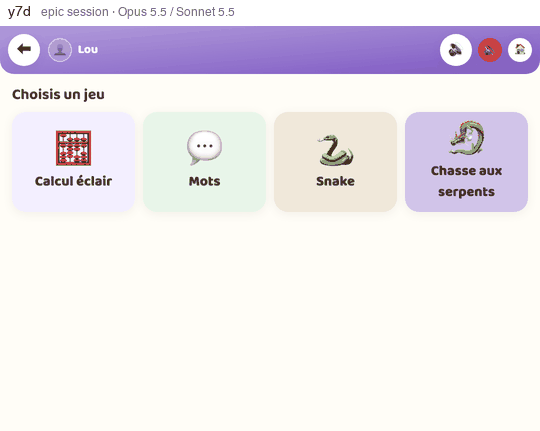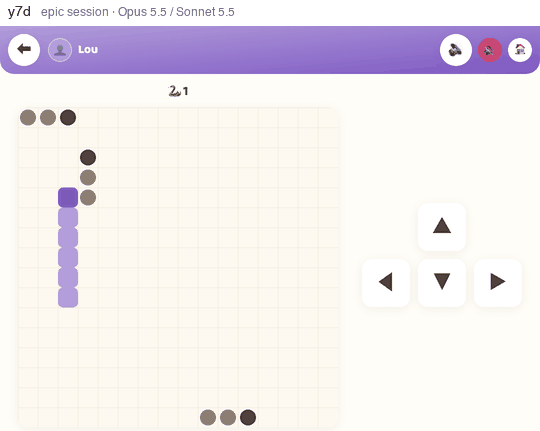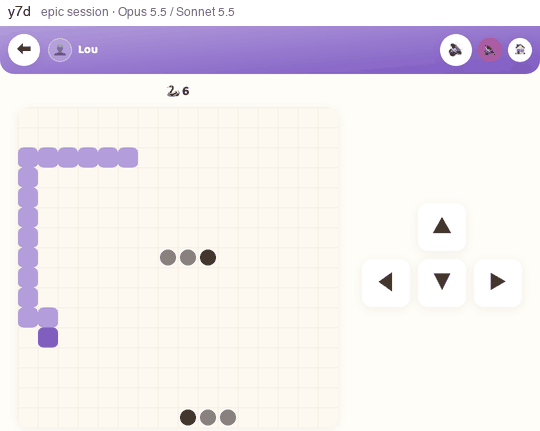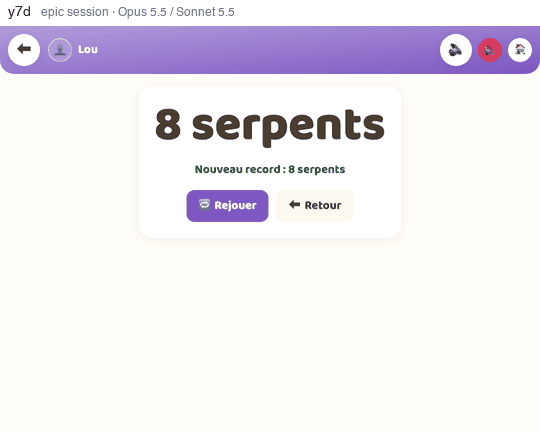
La misma partida con guion se grabó en cada build. Esta es la de uno de los ocho builds (y7d en las tablas de abajo).
La spec pasó por toda la cadena BMAD: requisitos, diseño UX, arquitectura, desglose en stories, y luego la spec y sus stories. Todos los builds partieron del mismo commit. Cada uno de los ocho builds agregó de 726 a 787 líneas de código de producción y de 1,450 a 2,142 líneas de tests unitarios. La redacción de la spec y sus reviews no se cuentan en ninguna de las cifras de tokens de abajo.
Las configuraciones
Cada configuración corrió a través de mi orquestador, con Claude Code como harness.
| Build | Workflow | Sesión orquestadora | Plan y review | Implementación |
|---|---|---|---|---|
y3f | staged | ninguna, el orquestador inicia cada paso | Opus 5.5 | Sonnet 5.5 |
t4e | story session | Sonnet 5.5 | Opus 5.5 | Sonnet 5.5 |
y7d | epic session | Sonnet 5.5 | Opus 5.5 | Sonnet 5.5 |
h5k | staged | ninguna | Sonnet 5.5 | Haiku 5.5 |
j5c | story session | Sonnet 5.5 | Sonnet 5.5 | Haiku 5.5 |
v2m | epic session | Sonnet 5.5 | Sonnet 5.5 | Haiku 5.5 |
k3x | sesión simple | una sesión de Sonnet 5.5 | — | — |
r8n | sesión simple | una sesión de Haiku 5.5 | — | — |
Dos límites de esta tabla: ningún build tuvo a Opus orquestando, y la plantilla simple usa un solo modelo, así que k3x y r8n no son el par en el que Sonnet planifica y Haiku implementa. j5c y v2m corrieron con una versión posterior del orquestador y de la plantilla, con los prompts sin cambios.
Los cuatro workflows
Cada paso de agente escribe un archivo marcador con su estado. Un paso que no deja un marcador legible está configurado para reintentarse una vez. Un agente bloqueado consulta a un modelo senior cuando el run tiene uno definido, y se pone en pausa a la espera de una persona cuando no. Los tres primeros workflows comparten todo lo que rodea al build: el gate de la spec antes, y después la verificación de tests unitarios, la generación de tests end-to-end (e2e), el quality gate e2e y la retrospectiva.
Staged. Mi orquestador inicia cada paso como su propia sesión de agente: tres sesiones por story, cada una con su propio modelo. El diagrama muestra a dónde vuelve el trabajo cuando hay un fallo.
flowchart TB
  gate[Gate de la spec, modelo de plan]:::agent
  subgraph story [Cada story, agentes reintentados una vez]
    plan[Plan, modelo de plan]:::agent --> impl[Implementación, modelo de implementación]:::agent
    impl --> verify(Verificación: tests unitarios):::check
    verify --> review[Review, modelo de review]:::agent
  end
  gate --> plan
  verify -. falla: rehacer, máximo 2 .-> impl
  review --> more{¿Más stories?}:::check
  more -->|sí| plan
  more -->|no| gen[Generación E2E, modelo de plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. falla: rehacer, máximo 2 .-> gen
  e2e --> retro[Retrospectiva, modelo de plan]:::agent
  retro --> pr([Push hecho, enlace a la PR]):::check
  story -. bloqueado .-> senior[Consulta al senior, si está definido]:::agent
  verify -. sigue fallando .-> senior
  senior -->|decisión| story
  senior -. no definido .-> park([Pausa para una persona]):::gate
  gate -. bloqueado .-> park
  e2e -. sigue fallando .-> park
  retro -. rechazada .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Story session. Una sesión de Claude Code por story lanza las mismas tres etapas como subagentes, con los mismos modelos: el harness inicia las etapas en lugar de mi orquestador. La verificación corre después de la sesión, y un fallo está configurado para mandar a repetir toda la sesión. La siguiente story inicia una sesión nueva.
flowchart TB
  gate[Gate de la spec, modelo de plan]:::agent
  subgraph session [Una sesión por story, Sonnet, reintentada una vez]
    plan[Subagente de plan]:::agent --> impl[Subagente de implementación]:::agent --> review[Subagente de review]:::agent
  end
  gate --> session
  review --> verify(Verificación: tests unitarios):::check
  verify -. falla: rehacer, máximo 2 .-> session
  verify --> more{¿Más stories?}:::check
  more -->|sí, nueva sesión| session
  more -->|no| gen[Generación E2E, modelo de plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. falla: rehacer, máximo 2 .-> gen
  e2e --> retro[Retrospectiva, modelo de plan]:::agent
  retro --> pr([Push hecho, enlace a la PR]):::check
  session -. bloqueado .-> senior[Consulta al senior, si está definido]:::agent
  verify -. sigue fallando .-> senior
  senior -->|decisión| session
  senior -. no definido .-> park([Pausa para una persona]):::gate
  gate -. bloqueado .-> park
  e2e -. sigue fallando .-> park
  retro -. rechazada .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Epic session. Una sola sesión para todo el epic ejecuta las tres etapas para cada story, en orden, y luego la verificación corre una vez para el epic.
flowchart TB
  gate[Gate de la spec, modelo de plan]:::agent
  subgraph session [Una sesión para el epic, Sonnet, reintentada una vez]
    plan[Subagente de plan]:::agent --> impl[Subagente de implementación]:::agent --> review[Subagente de review]:::agent
    review --> more{¿Siguiente story?}:::check
    more -->|sí| plan
  end
  gate --> session
  more -->|no| verify(Verificación: tests unitarios):::check
  verify -. falla: rehacer, máximo 2 .-> session
  verify --> gen[Generación E2E, modelo de plan]:::agent
  gen --> e2e(Quality gate E2E):::check
  e2e -. falla: rehacer, máximo 2 .-> gen
  e2e --> retro[Retrospectiva, modelo de plan]:::agent
  retro --> pr([Push hecho, enlace a la PR]):::check
  session -. bloqueado .-> senior[Consulta al senior, si está definido]:::agent
  verify -. sigue fallando .-> senior
  senior -->|decisión| session
  senior -. no definido .-> park([Pausa para una persona]):::gate
  gate -. bloqueado .-> park
  e2e -. sigue fallando .-> park
  retro -. rechazada .-> park
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Sesión simple de Claude Code. Una sesión recibe la carpeta de la spec y un prompt, que le pide hacer pasar los tests y el quality gate completo. Sin gate de la spec, sin etapas, sin verificación, sin pasos e2e, sin retrospectiva y sin consulta al senior. El orquestador solo hace checkout, commit y push; nunca corre los tests, así que es la calificación después del run la que dice el resultado.
flowchart TB
  pin(Fijar el commit, instalar):::check --> build[Una sesión construye el epic]:::agent
  build -. sin marcador: reintentar una vez .-> build
  build -->|listo| push(Commit y push):::check
  push --> pr([Enlace a la PR]):::check
  build -. bloqueado .-> park([Pausa para una persona]):::gate
  classDef agent fill:#ffffff,stroke:#3d4654,color:#111827
  classDef check fill:#f2f5f4,stroke:#6b7280,color:#111827
  classDef gate fill:#e8f0ee,stroke:#006b56,stroke-width:2px,color:#111827
Fuentes.
- Las specs siguen BMAD Method, que se describe a sí mismo como “Agile AI-Driven Development” (documentación de BMAD Method).
- En la story session y la epic session, Claude Code delega en sus propios subagentes, cada uno con su propio modelo: “Control costs by routing tasks to faster, lower-cost models like Haiku” (Create custom subagents, documentación de Claude Code).
2. Los hallazgos
Antes de los runs, esperaba que el par Sonnet y Haiku fuera el más barato, pero también el que fallara, o al menos el que fallara algunas veces.
Me sorprendió que todas las versiones del workflow dieran el mismo resultado desde el punto de vista de la experiencia de usuario: el juego funcionaba correctamente, las pantallas estaban bien desarrolladas, las interacciones funcionaban, todas equivalentes entre sí. Probé todas las versiones en la tablet: jugué cada una varias veces, perdí y gané un par de veces en cada una, y no observé ninguna diferencia. Honestamente, no esperaba el mismo resultado en todas las versiones.
La equivalencia se mide sobre los ocho builds:
- Un script jugó las mismas 6,000 partidas en los ocho motores del juego, con los mismos sorteos aleatorios y las mismas teclas: los ocho devolvieron el mismo estado en cada paso. Una partida con guion de 124 ticks muestra además el mismo tablero en cada tick en la pantalla real de cada build.
- Los tests unitarios de cada build pasan sobre el código de los otros siete en 8,377 de 8,470 ejecuciones de casos, y sus specs e2e sobre las aplicaciones de los otros siete en 3,231 de 3,234. Cada fallo es un test ligado a una decisión que la spec dejó abierta.
- Los ocho están en verde en el quality gate completo del repositorio (la suite de toda la aplicación, no solo los tests de la funcionalidad), con una cobertura de líneas del 93.3 al 93.6 %.
- Mi calificación en la tablet, hecha en siete de los ocho sin saber qué build estaba jugando, dio el mismo resultado cada vez.
Una advertencia antes de los números: cada configuración corrió una vez. Un estudio de 2026 sobre agentes de código en un solo repositorio encontró que una ganancia medida en la tasa de éxito, con el número de tareas que aporta un repositorio, “cannot be separated from the agent’s run-to-run variance”. Una diferencia en lo que sigue es una diferencia entre dos runs.
| Build | Workflow | Modelos | Costo | Tokens de prompt | Tokens de salida | Minutos de ejecución |
|---|---|---|---|---|---|---|
y3f | staged | Opus / Sonnet | $16.50 | 22.3M | 219k | 122 |
t4e | story session | Opus / Sonnet | $15.68 | 20.2M | 234k | 85 |
y7d | epic session | Opus / Sonnet | $16.56 | 21.9M | 230k | 103 |
h5k | staged | Sonnet / Haiku | $2.77 a $3.50 | 17.8M | 209k | 90 |
j5c | story session | Sonnet / Haiku | $3.33 a $4.84 | 27.2M | 277k | 61 |
v2m | epic session | Sonnet / Haiku | $2.67 a $4.01 | 19.8M | 255k | 54 |
k3x | simple | Sonnet | $2.33 (estimación) | 6.57M | 70k | 19 |
r8n | simple | Haiku | $0.25 a $1.11 (estimación) | 12.25M | 132k | 40 |
El costo es un precio, no una factura: mi gateway LiteLLM calculó el precio de cada solicitud a tarifas de API (noviembre de 2026), mientras que los builds corrieron con mi suscripción. El gateway no tenía precio para Haiku por encima de 100k tokens de contexto, así que su cifra es un límite inferior; la cifra superior es la estimación propia de Claude Code. Los dos builds simples nunca pasaron por el gateway: sus dólares son estimaciones y sus tokens son el conteo del orquestador, así que los comparo en tokens, y de forma aproximada. Los tokens de prompt incluyen las lecturas de caché.
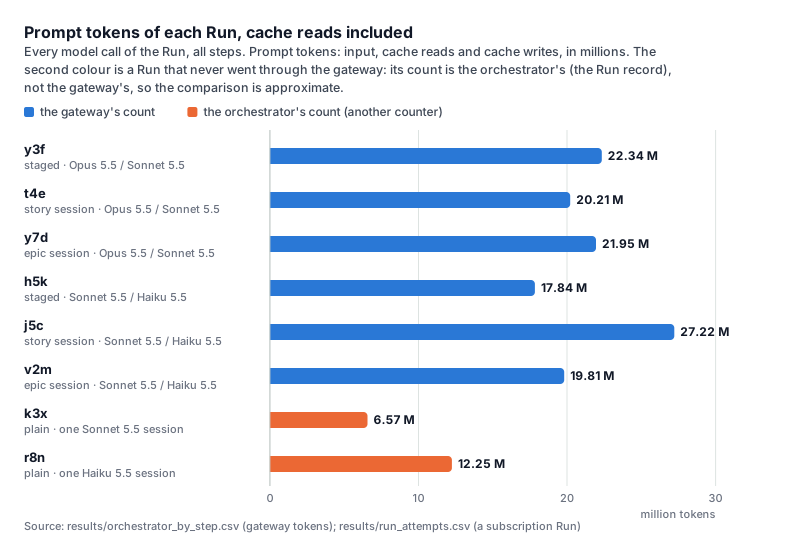
Tres cosas destacan:
- El par de modelos movió el costo de tres a seis veces. Los conteos de tokens de los dos pares son parecidos; lo que cambia es el precio por token.
- El método lo movió poco con Opus y Sonnet (de 20.2M a 22.3M tokens de prompt) y más con Sonnet y Haiku (de 17.8M a 27.2M).
- Las sesiones simples de Claude Code fueron las que usaron menos tokens y menos tiempo, sin ninguno de los pasos alrededor del build.
El tercer punto es el que me quedó dando vueltas: la configuración que necesitaba hace seis meses ya la cubren los harnesses.
Fuentes.
- Un run por configuración: el estudio sobre la variabilidad entre runs en un solo repositorio (Skill Issue: Lessons from Optimizing Repository SKILLs for Coding Agents, preprint de 2026).
- Los precios de API detrás de la columna de costo, a noviembre de 2026. Haiku 5.5 tiene un segundo precio, más alto, para prompts de más de 100,000 tokens (Pricing, documentación de la API de Claude).
- Claude Code calcula su propia cifra en dólares “locally from token counts at list price”, como estimación (Manage costs effectively, documentación de Claude Code).
3. Observaciones interesantes
| # | Pregunta | Respuesta corta |
|---|---|---|
| 1 | ¿Mi orquestación antes o después del desarrollo es una barrera de protección que ayuda a los agentes de baja capacidad a llegar al objetivo? | No en esta funcionalidad. La verificación y el gate e2e no detuvieron ningún defecto en los seis runs orquestados, y la sesión simple de Haiku llegó al mismo juego sin ningún gate. |
| 2 | ¿Esos pasos son inútiles cuando se usan modelos de alta capacidad? | Encontraron poco que reparar: 7 patches de review en los tres builds con Opus y Sonnet, ninguno por algo con lo que un usuario se habría topado. “Inútiles” es más de lo que puede decir un run por configuración. |
| 3 | ¿El consumo de tokens es equivalente con los mismos modelos pero distintos métodos? | Con Opus y Sonnet, sí (de 20.2M a 22.3M tokens de prompt). Con Sonnet y Haiku, no (de 17.8M a 27.2M), aunque el run más alto repitió un paso dos veces. |
| 4 | ¿Qué combinación de método y modelos es la menos eficiente, o la más costosa sin que valga la pena? | El par Opus y Sonnet, sea cual sea el método: de tres a seis veces el costo por el mismo juego y tests e2e un poco más sólidos. |
| 5 | ¿Qué paso de mi orquestador es inútil o redundante? | En esta spec, el paso de generación e2e: de 0 a 5 tests agregados después de que las stories escribieran los suyos. Por ahora lo mantengo como red de seguridad, y la retrospectiva para el autoaprendizaje. |
| 6 | ¿Los tests son equivalentes: e2e generados, tests unitarios, cobertura? | La cobertura sí: del 93.3 al 93.6 % de las líneas. Lo que detectan los tests no: de 8 a 13 de 13 defectos inyectados en la pantalla del juego. |
| 7 | ¿Cuántos reintentos, fallos y desbloqueos del senior? | Nueve intentos fallidos en tres runs, ninguno causado por el código, y ninguna consulta al senior en ningún run. Los runs me esperaron unos 133 minutos, 131 de ellos por infraestructura. |
Abajo, más detalles sobre cada una de estas preguntas.
1. ¿Mi orquestación es una barrera de protección que ayuda a los agentes de baja capacidad a llegar al objetivo?
| Build | Verificación de tests unitarios fallida por el código | Gate E2E fallido por un test | Ejecuciones de tests que lanzaron los propios agentes (unitarios / e2e) | Quality gate completo después del run |
|---|---|---|---|---|
y3f | 0 de 3 | 0 de 4 | 30 / 20 | verde |
t4e | 0 de 3 | 0 de 1 | 22 / 8 | verde |
y7d | 0 de 1 | 0 de 1 | 29 / 14 | verde |
h5k | 0 de 3 | 0 de 1 | 42 / 17 | verde |
j5c | 0 de 3 | 0 de 4 | 32 / 14 | verde |
v2m | 0 de 1 | 0 de 1 | 30 / 11 | verde |
k3x | sin gate | sin gate | 8 / 5 | verde |
r8n | sin gate | sin gate | 13 / 5 | verde |
Los gates no tenían nada que atrapar: los agentes corrieron las mismas suites por su cuenta antes de entregar (30 ejecuciones unitarias y 20 e2e solo en y3f) y corrigieron lo que fallaba dentro del paso. Así que los gates confirmaron que el build estaba en verde. La sesión simple de Haiku, sin ningún gate, también sale en verde; sus tests son otro tema (pregunta 6).
Inyecté 16 defectos en el motor de cada build para ver qué detectan sus tests (pregunta 6): a los ocho se les escapan los mismos tres, los que los criterios de aceptación no describen. Los ocho builds también escribieron los mismos 18 archivos de producción. Siguen la spec de cerca; ningún run varió la spec, así que no está medido cuánto del resultado se debe a ella.
2. ¿Esos pasos son inútiles cuando se usan modelos de alta capacidad?
| Build | Revisor | Duración de un review | Patches del review | Defectos de código o huecos de tests señalados por la retrospectiva |
|---|---|---|---|---|
y3f | Opus | 69 a 739 s | 3 | 9 |
t4e | Opus | 104 a 804 s | 2 | 11 |
y7d | Opus | 78 a 774 s | 2 | 6 |
h5k | Sonnet | 28 a 39 s | 0 | 1 |
j5c | Sonnet | 21 a 40 s | 0 | 0 |
v2m | Sonnet | 19 a 29 s | 0 | 1 |
k3x | sin review | — | — | sin retrospectiva |
r8n | sin review | — | — | sin retrospectiva |
Con Opus, los pasos leyeron el código, volvieron a correr las suites y agregaron tests y hallazgos; ninguno de los 7 patches corrigió algo con lo que un usuario se habría topado. Con Sonnet, sobre todo confirmaron lo que el implementador ya había corrido: cinco de los nueve reviews no ejecutaron ningún comando. Las retrospectivas señalaron 26 defectos de código o huecos de tests en los tres builds con Opus y Sonnet, y 2 en los otros tres; una retrospectiva los reporta y no repara nada.
Eso sí, “inútiles” es más de lo que pueden decir los datos: el revisor y el implementador cambiaron juntos (Opus revisó el código de Sonnet, Sonnet revisó el de Haiku), y ninguna sesión simple de Claude Code corrió con Opus.
3. ¿El consumo de tokens es equivalente con los mismos modelos pero distintos métodos?
| Build | Workflow | Tokens de prompt | Frente al build staged de los mismos modelos | Tokens de salida | Llamadas a herramientas |
|---|---|---|---|---|---|
y3f | staged, Opus / Sonnet | 22.3M | — | 219k | 323 |
t4e | story session, Opus / Sonnet | 20.2M | −10 % | 234k | 284 |
y7d | epic session, Opus / Sonnet | 21.9M | −2 % | 230k | 291 |
h5k | staged, Sonnet / Haiku | 17.8M | — | 209k | 214 |
j5c | story session, Sonnet / Haiku | 27.2M | +53 % | 277k | 325 |
v2m | epic session, Sonnet / Haiku | 19.8M | +11 % | 255k | 245 |
k3x | simple, Sonnet | 6.57M | otro contador, no comparable | 70k | 47 |
r8n | simple, Haiku | 12.25M | otro contador, no comparable | 132k | 75 |
Con Opus y Sonnet, los tres métodos costaron de $15.68 a $16.56, con un 6 % de diferencia. Eso está cerca de la diferencia, de más o menos 3 a 4 %, entre el gateway y la estimación propia de Claude Code sobre los mismos runs. Con Sonnet y Haiku, la story session usó un 53 % más de tokens que el run staged, pero j5c repitió dos veces su generación e2e (pregunta 7) y corrió con una versión posterior del orquestador, así que un solo run no permite decir que la causa sea el método.
Los números no zanjan mi hipótesis. Con Opus y Sonnet, la epic session, donde un agente recorre en bucle todo el proceso, usó un poco menos de tokens que el run staged; con Sonnet y Haiku, un 11 % más. La sesión simple de Sonnet usó cerca de un tercio de los tokens de los builds con Opus y Sonnet, y la sesión simple de Haiku, entre la mitad y dos tercios de lo que usaron los builds con Sonnet y Haiku, pero se saltaron el gate de la spec, la generación e2e y la retrospectiva, así que no es una comparación de igual a igual. Haiku por sí solo usó cerca del doble de tokens y de tiempo que Sonnet por sí solo para el mismo resultado en verde, y cerca de la mitad de ese tiempo se perdió en un comando cortado (pregunta 7).
4. ¿Qué combinación de método y modelos es la menos eficiente?
| Build | Modelos | Costo | Defectos de pantalla detectados por sus specs e2e (de 13) | Por sus tests de componentes | Por cualquiera de los dos |
|---|---|---|---|---|---|
y3f | Opus / Sonnet | $16.50 | 11 | 10 | 12 |
t4e | Opus / Sonnet | $15.68 | 10 | 10 | 11 |
y7d | Opus / Sonnet | $16.56 | 11 | 12 | 13 |
h5k | Sonnet / Haiku | $2.77 a $3.50 | 8 | 9 | 10 |
j5c | Sonnet / Haiku | $3.33 a $4.84 | 9 | 10 | 12 |
v2m | Sonnet / Haiku | $2.67 a $4.01 | 7 | 11 | 12 |
k3x | Sonnet, simple | $2.33 (estimación) | 10 | 10 | 11 |
r8n | Haiku, simple | $0.25 a $1.11 (estimación) | 8 | 6 | 8 |
El par Opus y Sonnet es el que cuesta más sin ganar mucho. Lo que se obtuvo con el costo adicional está en los tests: inyecté los mismos 13 defectos en la pantalla del juego de cada build y corrí los propios tests de ese build. Las specs e2e de los builds con Opus y Sonnet detectan de 10 a 11, contra 7 a 9 en los builds con Sonnet y Haiku; con los tests de componentes la brecha casi se cierra. La sesión simple de Sonnet está en el mismo rango, y la sesión simple de Haiku queda última.
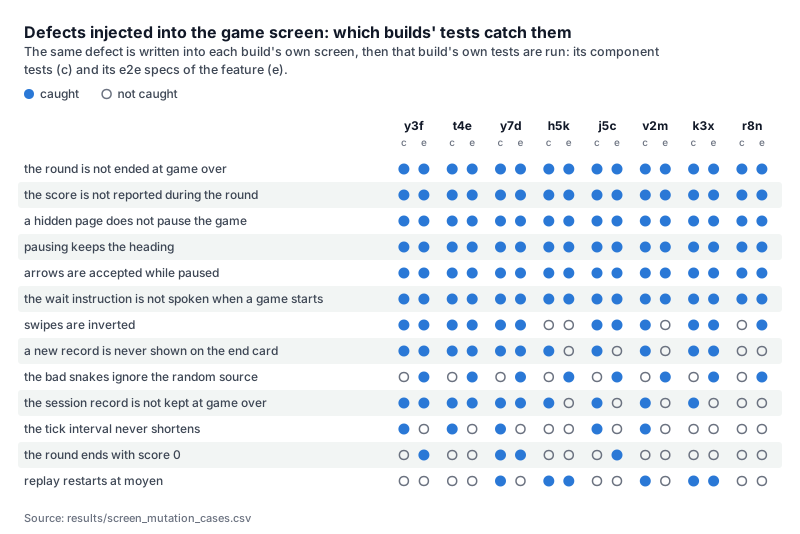
5. ¿Qué paso de mi orquestador es inútil o redundante?
| Build | Gate de la spec | Build | Generación E2E | Retrospectiva | Tests agregados por la generación e2e |
|---|---|---|---|---|---|
y3f staged, Opus / Sonnet | $0.60 | $8.74 | $2.43 | $4.73 | 3 |
t4e story session, Opus / Sonnet | $0.49 | $10.75 | $1.08 | $3.37 | 5 |
y7d epic session, Opus / Sonnet | $0.55 | $11.81 | $1.01 | $3.18 | 1 |
h5k staged, Sonnet / Haiku (límite inferior) | $0.18 | $2.12 | $0.15 | $0.32 | 0 |
j5c story session, Sonnet / Haiku (límite inferior) | $0.17 | $2.39 | $0.46 | $0.30 | 0 |
v2m epic session, Sonnet / Haiku (límite inferior) | $0.18 | $2.02 | $0.19 | $0.28 | 0 |
k3x simple, Sonnet (estimación) | sin paso | $2.33 | sin paso | sin paso | — |
r8n simple, Haiku (estimación) | sin paso | $0.25 a $1.11 | sin paso | sin paso | — |
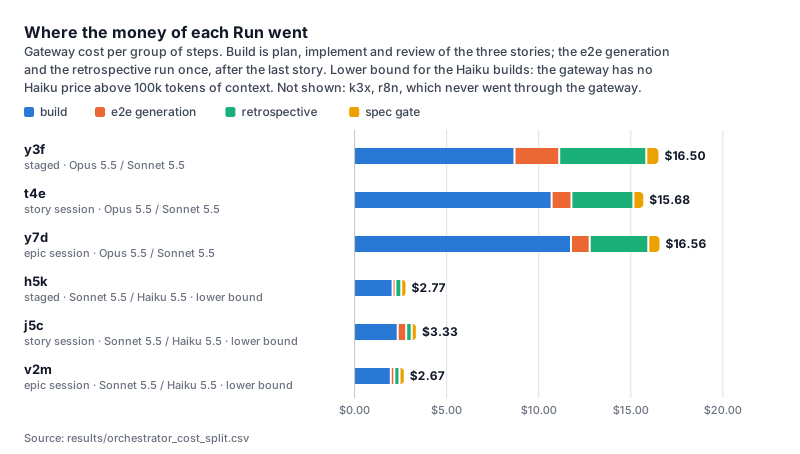
En esta spec, el paso de generación e2e es redundante. La spec les pide a las stories 2 y 3 escribir su propia spec e2e, así que el paso llegó cuando la cobertura ya existía. Todos los modelos escribieron que las stories habían cubierto la funcionalidad, y luego agregaron de 0 a 5 tests, que pasaron todos sobre código que nadie cambió.
Después del build, la retrospectiva es el paso más caro en cinco de los seis runs: del 9 al 29 % del costo de cada run. Las seis terminaron con el mismo veredicto, aceptado con puntos abiertos. La verificación y el gate e2e nunca detuvieron un defecto, pero son determinísticos, duran unos 10 y 630 segundos respectivamente, y son la prueba de que el build está en verde. Los pasos de plan y el gate de la spec no se analizaron.
Creo que la generación e2e es una red de seguridad para posibles bugs, y la retrospectiva se usa para el autoaprendizaje. Así que por ahora mantengo los dos. Los mantendría durante el onboarding de un proyecto; una vez que cada run sea estable (sin bugs, sin regresiones), se podrían quitar para ahorrar tokens.
6. ¿Los tests son equivalentes: e2e generados, tests unitarios, cobertura?
| Build | Casos de tests unitarios escritos | Casos E2E escritos | Cobertura de líneas del repositorio | Cobertura de líneas de las pantallas del juego que escribió | Defectos del motor detectados (de 16) |
|---|---|---|---|---|---|
y3f | 100 | 24 | 93.62 % | 100 % | 13 |
t4e | 95 | 27 | 93.63 % | 100 % | 13 |
y7d | 102 | 24 | 93.64 % | 100 % | 13 |
h5k | 93 | 17 | 93.38 % | 95.28 % | 13 |
j5c | 111 | 22 | 93.61 % | 99.56 % | 13 |
v2m | 117 | 18 | 93.64 % | 100 % | 12 |
k3x | 79 | 19 | 93.63 % | 100 % | 13 |
r8n | 74 | 18 | 93.32 % | 94.78 % | 13 |
La cobertura del repositorio no distingue a los builds. La de las pantallas del juego, un poco: h5k y r8n, con 95 %, son también los dos builds cuyos tests detectan menos defectos de pantalla (pregunta 4). Los builds con Sonnet y Haiku escribieron suites e2e más cortas (de 17 a 22 casos contra 24 a 27), y las sesiones simples fueron las que escribieron menos tests unitarios, con la mayor parte de la diferencia en las pantallas que usa el niño. v2m escribió más tests unitarios que cualquiera de los ocho y es el único build cuyos tests del motor dejan pasar un defecto que los demás detectan. Ninguna suite e2e de los ocho nota que el juego deja de acelerar.
7. ¿Cuántos reintentos, fallos y desbloqueos del senior?
| Build | Intentos fallidos | Pasos devueltos | Reintentos automáticos | Pausas | Consultas al senior | Minutos esperándome |
|---|---|---|---|---|---|---|
y3f | 3 | 2 | 0 | 1 | 0 | 100 |
t4e | 0 | 0 | 0 | 0 | 0 | 0 |
y7d | 0 | 0 | 0 | 0 | 0 | 0 |
h5k | 3 | 0 | 0 | 3 | 0 | 32 |
j5c | 3 | 2 | 0 | 1 | 0 | 1 |
v2m | 0 | 0 | 0 | 0 | 0 | 0 |
k3x | 0 | 0 | 0 | 0 | sin senior | 0 |
r8n | 0 | 0 | 0 | 0 | sin senior | 0 |
Ninguno de los nueve intentos fallidos fue un agente atascado en el código. En y3f y j5c, el gate e2e no pudo arrancar tres veces porque el servidor de tests de un agente anterior todavía ocupaba su puerto, y los fallos devolvieron el paso de generación e2e dos veces en cada run ($1.48 y $0.31 de trabajo repetido). En h5k, una actualización de submódulo excedió el tiempo límite dos veces, y un paso de implementación se bloqueó en una frase de la spec, que respondí en menos de dos minutos. Ningún run consultó a un modelo senior: los tres builds con Opus y Sonnet corrieron sin uno, y j5c y v2m tenían a Opus 5.5 como senior y nunca lo llamaron.
La mayor pérdida de tiempo no fue un paso: la suite e2e completa tarda unos diez minutos, la duración máxima de un comando en el harness, así que cuando un agente la corre en primer plano, el comando se corta y el servidor de tests queda ocupando el puerto. Eso le costó a y3f su pausa de 100 minutos, y a la sesión simple de Haiku unos 20 de sus 40 minutos.
Tengo una sesión de Claude en el host vigilando los runs: cuando un run se pone en pausa, recibo un mensaje de Claude. Así que el tiempo en pausa es el tiempo que estuve lejos de mi teléfono o de mi computadora (wow, mucho tiempo, al parecer).
Conclusión
Después de ver que los resultados eran los mismos con las distintas configuraciones de modelos de IA, creo que la funcionalidad era demasiado simple y fácil: no era un desafío suficiente, ni siquiera para modelos de muy baja capacidad (la aplicación ya tenía un primer juego Snake, y del 69 al 87 % de cada nuevo componente de pantalla del juego es la pantalla de ese juego, adaptada). Las métricas de los builds son distintas entre sí, pero el resultado fue el mismo, lo que me hizo pensar en la complejidad real de la tarea.
La configuración que necesitaba hace seis meses ya es obsoleta, al menos con Claude Code. ¡La tecnología avanza rápido y tenemos que seguirle el paso! Esto deja espacio para más exploraciones con distintas configuraciones y métodos.
Después de estas observaciones, me queda una pregunta más: ¿estos resultados prueban que la definición de la spec es lo que garantiza el resultado final, sin importar el modelo y el método? Gran parte de la planificación ya estaba hecha de antemano, así que quedaban muy pocas decisiones para el agente. Los ocho builds escribieron los mismos 18 archivos de producción, pero ningún run varió la spec, así que esta evaluación no puede responderla.
Para mis próximas funcionalidades, correría o bien el workflow staged con una mezcla de modelos, para tener más control, o bien una sesión por story. En los dos casos, el modelo debería ajustarse a la complejidad de cada story, ya que la complejidad de la story podría cambiar los resultados. Así que voy a integrar en mi orquestador la posibilidad de cambiar de modelo por story.
Como siguiente paso, voy a evaluar una funcionalidad más compleja con distintas configuraciones, para observar las diferencias.